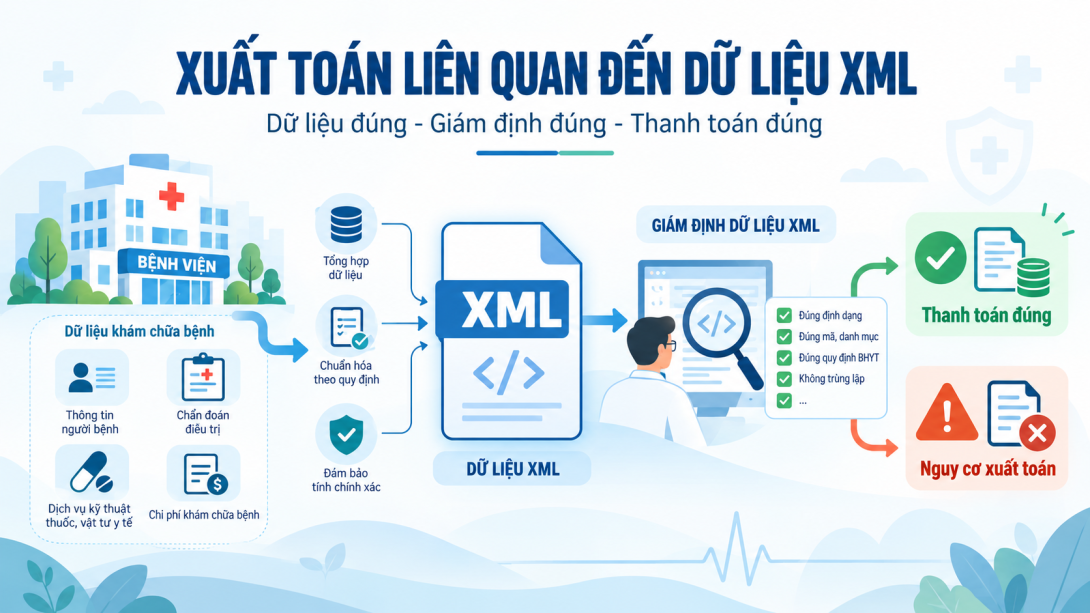
Từ Chương 1 đến Chương 6, dữ liệu XML chủ yếu được tiếp cận dưới góc độ:
- cấu trúc và chuẩn dữ liệu;
- danh mục và phiên bản;
- tính hợp lệ và nhất quán;
- nguy cơ ảnh hưởng thanh toán;
- giám định;
- điều chỉnh;
- giải trình;
- quyết toán và kết quả xử lý cuối cùng.
Chương 7 chuyển sang một câu hỏi rộng hơn:
Có thể khai thác dữ liệu XML để hiểu hoạt động khám chữa bệnh, nhận diện vấn đề chuyên môn và quản trị chi phí đến mức nào?
Đây là một hướng sử dụng rất có giá trị.
Từ hàng triệu dòng XML, cơ sở khám chữa bệnh có thể phát hiện:
- nhóm bệnh có chi phí tăng;
- khoa có thay đổi mô hình sử dụng thuốc hoặc DVKT;
- dịch vụ có tần suất chỉ định khác biệt;
- thời gian điều trị thay đổi;
- tỷ lệ tái khám tăng;
- nhóm thuốc tăng nhanh;
- cơ cấu chi phí chuyển dịch;
- những hồ sơ hoặc nhóm hồ sơ cần được rà soát sâu hơn.
Nhưng chính khả năng phân tích quy mô lớn cũng tạo ra một rủi ro mới:
biến một dấu hiệu thống kê thành kết luận chuyên môn hoặc kết luận thanh toán khi dữ liệu chưa đủ để chứng minh.
Một khoa có chi phí bình quân cao hơn khoa khác chưa chắc sử dụng chi phí không hợp lý.
Một bác sĩ chỉ định xét nghiệm nhiều hơn trung bình chưa chắc chỉ định quá mức.
Một nhóm bệnh có thời gian điều trị dài hơn chưa chắc điều trị không hiệu quả.
Một thuốc xuất hiện nhiều với một chẩn đoán chưa chứng minh thuốc đó chỉ được phép sử dụng cho chẩn đoán ấy.
Một người bệnh quay lại sau thời gian ngắn chưa chắc là tái khám bất hợp lý.
Vì vậy nguyên tắc trung tâm của Chương 7 là:
Phân tích dữ liệu dùng để xác định nơi cần xem xét; không dùng bất thường thống kê để thay thế việc đánh giá hồ sơ, bối cảnh chuyên môn và căn cứ áp dụng.
1. Căn cứ pháp lý cho việc sử dụng phân tích dữ liệu
Điều 11 Thông tư 12/2026/TT-BTC quy định trong giám định chủ động, cơ quan BHXH thực hiện rà soát, đối chiếu quy định pháp luật với hồ sơ và tài liệu liên quan đến chi phí đề nghị thanh toán.
Đặc biệt, đối với hồ sơ bệnh án, tài liệu thanh toán và kết quả tự rà soát chi phí tăng cao, cơ quan BHXH:
phân tích dữ liệu KCB, đánh giá mức độ cảnh báo, thông báo số lượng hồ sơ và nội dung để cơ sở tự rà soát hằng tháng;
sau đó mới xác định nội dung và số hồ sơ cần giám định trực tiếp, đối chiếu với hồ sơ bệnh án và tài liệu do cơ sở cung cấp.
Cấu trúc này rất quan trọng.
Nó cho thấy:
phân tích dữ liệu → lựa chọn nội dung/hồ sơ cần rà soát → đối chiếu hồ sơ/tài liệu → kết luận.
Không phải:
phân tích dữ liệu → thấy bất thường → tự động kết luận sai.
2. Điều 13 cũng sử dụng khái niệm “cảnh báo”, không đồng nhất với sai phạm
Điều 13 quy định cơ quan BHXH cảnh báo cơ sở có chi phí KCB BHYT tăng cao so với:
- chi phí bình quân của cơ sở cùng cấp chuyên môn kỹ thuật;
- cùng loại hình đa khoa hoặc chuyên khoa;
- trên địa bàn tỉnh/thành phố hoặc toàn quốc;
- hoặc mức tăng bình quân của chính cơ sở so với cùng kỳ năm trước.
Mức cảnh báo được phân thành:
- tăng thấp;
- tăng cao;
- tăng rất cao.
Sau khi nhận cảnh báo, cơ sở có trách nhiệm:
rà soát, kiểm tra chi phí; xác định nguyên nhân chủ quan và khách quan; xây dựng giải pháp khắc phục nguyên nhân chủ quan, bất cập.
Như vậy:
cảnh báo tăng chi ≠ kết luận chi phí không hợp lý.
Nó là:
tín hiệu yêu cầu phân tích nguyên nhân.
3. Đây là khác biệt giữa “analytics” và “adjudication”
Chương 7 phải giữ ranh giới này rất rõ.
Analytics
Trả lời:
Có điểm nào khác thường?
Nhóm nào thay đổi?
Hồ sơ nào nên được xem xét?
Xu hướng nào cần giải thích?
Adjudication
Trả lời:
Khoản chi cụ thể có đáp ứng quy định thanh toán hay không?
Một chỉ số thống kê có thể tạo:
WARN_REVIEW.
Nhưng muốn chuyển thành:
PAYMENT_CONDITION
vẫn phải quay về nguyên tắc của Chương 5:
**quy định áp dụng
- thời điểm áp dụng
- đối tượng áp dụng
- đủ bằng chứng
- chứng minh vi phạm.**
4. XML rất mạnh trong việc mô tả “cái gì đã được ghi nhận”
XML có thể cho biết nhiều thông tin có cấu trúc như:
- người bệnh;
- lần KCB;
- chẩn đoán;
- loại hình KCB;
- khoa;
- thuốc;
- DVKT;
- VTYT;
- người chỉ định/thực hiện;
- thời gian;
- số lượng;
- đơn giá;
- tỷ lệ thanh toán;
- các thành phần chi phí;
- kết quả CLS trong phạm vi XML4;
- diễn biến trong phạm vi XML5;
- các chứng từ điện tử chuyên biệt trong những bảng tương ứng.
Từ đó có thể xây dựng:
patient timeline
episode timeline
drug utilization profile
service utilization profile
cost profile
department profile
diagnosis profile
provider profile
longitudinal utilization profile.
Đây là nền tảng rất mạnh cho phân tích.
5. Nhưng XML không phải toàn bộ thực tế lâm sàng
XML không chứa đầy đủ mọi thông tin trong:
- khám bệnh;
- bệnh sử;
- khám lâm sàng;
- đánh giá mức độ nặng;
- mục tiêu điều trị;
- lựa chọn giữa nhiều phương án;
- lý do bác sĩ thay đổi kế hoạch;
- hoàn cảnh người bệnh;
- diễn biến chi tiết;
- hồ sơ chăm sóc;
- toàn bộ kết quả hình ảnh;
- toàn bộ nội dung hồ sơ bệnh án.
Do đó:
XML có thể cho thấy một pattern nhưng không phải lúc nào cũng giải thích được vì sao pattern đó xuất hiện.
Chương 7 sẽ luôn phải giữ nguyên tắc:
absence from XML ≠ absence from clinical care.
6. Một mối liên hệ thống kê không chứng minh quan hệ nhân quả
Ví dụ phân tích cho thấy:
người bệnh có chẩn đoán X thường dùng thuốc Y.
Điều đó cho biết:
association.
Không chứng minh:
X là chỉ định duy nhất của Y.
Tương tự:
khoa A sử dụng dịch vụ Z nhiều hơn khoa B
không chứng minh:
khoa A chỉ định quá mức.
Có thể có khác biệt về:
- cơ cấu bệnh;
- mức độ nặng;
- tuổi;
- bệnh kèm;
- tuyến chuyển đến;
- năng lực chuyên môn;
- mô hình bệnh tật;
- loại hình KCB.
Do đó:
correlation ≠ causation
và:
association ≠ payment condition.
7. Trước khi so sánh phải xác định đúng mẫu số
Một tỷ lệ chỉ có ý nghĩa khi denominator đúng.
Ví dụ:
số CT scanner / tổng lượt KCB
có thể ít ý nghĩa nếu cần phân tích:
số CT / số bệnh nhân thuộc nhóm có chỉ định tiềm năng.
Tương tự:
tổng tiền thuốc / tổng lượt
khác:
tổng tiền thuốc / số lượt có sử dụng thuốc
và khác:
tổng tiền thuốc / nhóm bệnh tương ứng.
Chọn sai denominator có thể tạo ra:
outlier giả.
8. So sánh phải điều chỉnh theo case-mix
Hai khoa có cùng 1.000 lượt bệnh không nhất thiết có chi phí tương đương.
Một khoa có thể điều trị:
- người bệnh cao tuổi hơn;
- nhiều bệnh nền hơn;
- bệnh nặng hơn;
- nhiều can thiệp hơn;
- nhiều ca chuyển tuyến phức tạp hơn.
Nếu chỉ so:
chi phí bình quân/lượt
mà bỏ qua case-mix:
kết luận rất dễ sai.
Do đó Chapter 7 phải hướng tới:
risk/context-adjusted analytics
thay vì chỉ:
raw average comparison.
9. Thời gian là một biến bắt buộc trong mọi phân tích
Một mã hoặc một hành vi không thể được phân tích tách khỏi:
thời điểm.
Phải xem:
- phiên bản danh mục nào có hiệu lực;
- giá nào đang áp dụng;
- loại hình KCB nào đang dùng;
- quy định nào còn hiệu lực;
- có thay đổi tổ chức bệnh viện hay không;
- có dịch bệnh hoặc thay đổi mô hình bệnh tật hay không.
Ví dụ năm 2026 có thay đổi MA_LOAI_KCB theo Quyết định 1804/QĐ-BYT.
Nếu phân tích xu hướng trước và sau thay đổi mà không normalize:
có thể coi thay đổi mã hóa là thay đổi hoạt động chuyên môn.
10. Data quality phải được kiểm tra trước analytics
Không nên chạy phân tích chuyên môn trên dữ liệu mà chưa biết:
- thiếu bao nhiêu;
- duplicate bao nhiêu;
- mapping sai bao nhiêu;
- version có đồng nhất không.
Một mức tăng thuốc có thể thực tế chỉ là:
tháng trước dữ liệu bị thiếu.
Một mức tăng lượt có thể là:
duplicate submission.
Một thời gian điều trị bất thường có thể là:
lỗi
NGAY_RA.
Do đó pipeline phải là:
validate → normalize → deduplicate → resolve version → analyze.
Không đảo ngược.
11. Cần phân biệt ba tầng bất thường
Bất thường dữ liệu
Ví dụ:
- giá trị ngoài miền hợp lệ;
- thời gian bất khả thi;
- duplicate;
- mã không đúng version.
→ xử lý bằng validation.
Bất thường thống kê
Ví dụ:
- tần suất cao hơn nhóm so sánh;
- chi phí tăng nhanh;
- length of stay khác biệt.
→ WARN_REVIEW.
Bất thường đã được chứng minh bằng chuyên môn/pháp lý
Sau khi rà soát hồ sơ và căn cứ:
mới có thể kết luận phù hợp hoặc không phù hợp.
Không được nhảy từ tầng 2 sang tầng 3.
12. Outlier là điểm bắt đầu của điều tra, không phải điểm kết thúc
Một outlier có thể xuất hiện vì:
- bệnh viện thực sự có vấn đề;
- bệnh viện có case-mix khác;
- thay đổi giá;
- thay đổi danh mục;
- dịch bệnh;
- tăng số ca nặng;
- mở kỹ thuật mới;
- chuyển người bệnh từ nơi khác đến;
- thay đổi coding;
- chất lượng dữ liệu thay đổi.
Do đó khi phát hiện:
OUTLIER
câu hỏi tiếp theo phải là:
“Vì sao?”
Không phải:
“Xuất toán bao nhiêu?”
13. Phải tách “screening threshold” khỏi “payment threshold”
Một ngưỡng thống kê có thể được đặt để:
tìm 5% hồ sơ cao nhất;
tìm bác sĩ có tần suất vượt percentile 95;
tìm nhóm chi phí tăng trên 30%.
Đây là:
screening threshold.
Nó không tự động trở thành:
payment threshold.
Nếu quy định thanh toán không quy định ngưỡng đó thì Dr5 không được chuyển nó thành:
PAYMENT_CONDITION.
14. Phân tích chuyên môn cần nhiều mức chứng cứ
Có thể hình dung:
Level 1 — Description
chuyện gì đang xảy ra?
Level 2 — Comparison
nhóm này khác nhóm kia thế nào?
Level 3 — Candidate detection
trường hợp nào cần rà soát?
Level 4 — Record review
hồ sơ cho thấy điều gì?
Level 5 — Clinical assessment
hành vi có hợp lý trong bối cảnh bệnh nhân không?
Level 6 — Payment assessment
có vi phạm điều kiện thanh toán cụ thể hay không?
XML mạnh nhất ở:
Level 1–3.
Từ Level 4 trở lên thường cần:
hồ sơ nguồn và đánh giá chuyên môn.
15. Phân tích chẩn đoán – thuốc – dịch vụ là một “graph”, không phải bảng mapping đơn giản
Không nên xây logic:
ICD X → chỉ được dùng thuốc Y.
Thực tế có thể là:
chẩn đoán
→ triệu chứng
→ xét nghiệm
→ kết quả
→ thuốc
→ theo dõi
→ thay đổi điều trị.
Một bệnh có nhiều treatment path.
Một thuốc có nhiều indication.
Một DVKT có nhiều mục tiêu.
Vì vậy Chương 7 sẽ phân tích:
relationship patterns
chứ không biến chúng thành:
hard payment rules
nếu không có căn cứ pháp lý cụ thể.
16. Phân tích tần suất cũng phải tính theo sự kiện nghiệp vụ
Không được tính:
số dòng XML = số lần thực hiện.
Phải xác định:
business event.
Ví dụ một xét nghiệm có nhiều chỉ số XML4.
Một DVKT có thể tạo nhiều dòng kết quả.
Một episode có thể được gửi nhiều version.
Trước khi tính frequency phải:
deduplicate submission → resolve episode → resolve event.
Đây là nguyên tắc đã đặt ở Bài 5.7.
17. Các chỉ số tần suất cần có cửa sổ thời gian rõ ràng
Ví dụ:
lần/ngày;
lần/7 ngày;
lần/30 ngày;
lượt/episode;
lượt/người/năm.
Không nên nói:
“dịch vụ này được làm nhiều”
mà không xác định:
nhiều trong cửa sổ nào.
Mọi frequency rule phải có:
subject + event + time window + denominator + comparison group.
18. Tái khám cần phân tích theo chuỗi longitudinal
Một người bệnh quay lại nhiều lần có thể do:
- bệnh mạn tính;
- hẹn điều trị;
- theo dõi sau can thiệp;
- dùng thuốc định kỳ;
- diễn biến xấu;
- điều trị chưa đạt;
- chuyển viện/chuyển khoa;
- hoặc sử dụng dịch vụ bất hợp lý.
XML cho phép phát hiện:
visit sequence.
Nhưng nguyên nhân cần:
clinical review.
Do đó:
frequent revisit = candidate, không phải kết luận chất lượng kém.
19. Thời gian điều trị cũng không được đánh giá bằng một ngưỡng chung
Length of stay phụ thuộc:
- chẩn đoán;
- mức độ nặng;
- phẫu thuật;
- biến chứng;
- tuổi;
- bệnh kèm;
- discharge disposition;
- availability of downstream care.
Do đó:
LOS cao
chỉ nên dẫn tới:
stratified review.
Không tự động:
inappropriate hospitalization.
20. Phân tích cơ cấu chi phí cần đi từ tổng xuống thành phần
Nếu tổng chi tăng 20%, câu hỏi tiếp theo phải là:
tăng do đâu?
Có thể decomposition thành:
volume effect
case-mix effect
price effect
intensity effect
service-mix effect
drug-mix effect
length-of-stay effect.
Điều này giúp phân biệt:
tăng chi hợp lý
với:
tăng do hành vi hoặc quy trình cần xem xét.
21. “Chi phí tăng” không đồng nghĩa “chi phí lãng phí”
Ví dụ tổng chi tăng vì:
số bệnh nhân tăng 30%
trong khi chi phí bình quân giảm.
Đó là một bức tranh hoàn toàn khác với:
số lượt không đổi nhưng chi phí/lượt tăng 30%.
Tương tự:
chi phí/lượt tăng do ca nặng tăng
khác:
chi phí/lượt tăng do số dịch vụ/lượt tăng.
Do đó phải phân tích:
drivers of change.
22. Điều 13 yêu cầu phân tích nguyên nhân chủ quan và khách quan
Điều 13 không yêu cầu cơ sở:
giảm mọi khoản tăng.
Cơ sở phải xác định:
nguyên nhân chủ quan
và:
nguyên nhân khách quan,
sau đó xây dựng giải pháp đối với các nguyên nhân chủ quan, bất cập.
Đây là một nền tảng rất quan trọng cho quản trị bệnh viện.
Một phân tích tốt không chỉ nói:
“chi phí tăng 25%”.
Mà phải tìm:
25% này đến từ đâu.
23. Có thể xây “cost driver tree”
Ví dụ:
Tổng chi BHYT
có thể phân rã thành:
số lượt
× chi phí bình quân/lượt.
Chi phí bình quân có thể phân thành:
thuốc
- DVKT
- VTYT
- tiền khám
- ngày giường
- các nhóm khác.
Mỗi thành phần tiếp tục phân tích theo:
- chẩn đoán;
- khoa;
- loại hình KCB;
- người bệnh;
- thời gian;
- dịch vụ.
Đây là cách tiếp cận hiệu quả hơn việc chỉ nhìn:
tổng tiền cuối cùng.
24. Nhóm so sánh phải được chọn trước khi kết luận outlier
Điều 13 đã đặt một nguyên tắc quan trọng khi so sánh:
cùng cấp chuyên môn kỹ thuật;
cùng loại hình đa khoa/chuyên khoa;
địa bàn hoặc toàn quốc;
hoặc so với chính cơ sở cùng kỳ năm trước.
Điều đó cho thấy:
comparator selection matters.
So một bệnh viện chuyên khoa ung bướu với bệnh viện đa khoa nhỏ:
rất dễ tạo conclusion sai.
25. Ngay cả “cùng nhóm” vẫn có thể cần điều chỉnh thêm
Hai bệnh viện cùng cấp vẫn có thể khác:
- tuổi người bệnh;
- referral pattern;
- tỷ lệ cấp cứu;
- tỷ lệ bệnh nặng;
- kỹ thuật chuyên sâu;
- vùng dịch tễ;
- cơ cấu BHYT.
Do đó analysis nâng cao có thể cần:
stratification
hoặc:
risk adjustment.
Nhưng phải minh bạch:
biến nào được dùng để điều chỉnh.
26. Không nên dùng một benchmark duy nhất
Một cơ sở có thể được so với:
- chính mình tháng trước;
- cùng kỳ năm trước;
- rolling 12 months;
- nhóm bệnh viện tương đồng;
- toàn tỉnh;
- toàn quốc;
- internal department peers.
Nếu tất cả đều chỉ về cùng một xu hướng:
signal mạnh hơn.
Nếu chỉ một comparator cho outlier:
cần thận trọng hơn.
27. Phân tích phải tách “volume” và “rate”
Ví dụ số xét nghiệm tăng 30%.
Có thể do:
số lượt tăng 30% nhưng xét nghiệm/lượt không đổi.
Hoặc:
số lượt không đổi nhưng xét nghiệm/lượt tăng 30%.
Hai tình huống cần hai cách xử lý khác nhau.
Do đó nên luôn phân tích:
count
và:
rate per relevant denominator.
28. Phải xem distribution, không chỉ average
Trung bình có thể che mất vấn đề.
Ví dụ chi phí bình quân khoa vẫn ổn định nhưng:
một nhóm nhỏ bệnh nhân có chi phí rất cao.
Ngược lại, median ổn định nhưng:
toàn bộ distribution dịch chuyển nhẹ.
Do đó analytics nên xem:
- mean;
- median;
- quantile;
- variance;
- tail;
- distribution by subgroup.
Nhưng các statistics này vẫn chỉ là:
evidence for screening.
29. Phân tích theo bác sĩ cần đặc biệt thận trọng
Một người hành nghề có chi phí trung bình cao có thể do:
- nhận ca nặng;
- chuyên môn sâu;
- phụ trách nhóm bệnh phức tạp;
- trực cấp cứu nhiều;
- referral bias.
Do đó không nên xây dashboard kiểu:
“bác sĩ chi phí cao = bác sĩ lạm dụng”.
Đúng hơn là:
provider-level review candidate.
Cần điều chỉnh theo:
patient mix + service context + role.
30. Analytics phải phục vụ chất lượng và an toàn, không chỉ giảm tiền
Một pattern bất thường có thể không ảnh hưởng BHYT nhưng lại quan trọng về chuyên môn.
Ví dụ:
- xét nghiệm quan trọng ít được chỉ định;
- follow-up bị thiếu;
- khoảng cách dùng thuốc bất thường;
- kết quả nguy hiểm nhưng không thấy xử trí tiếp theo;
- tái nhập viện sớm tăng;
- length of stay quá ngắn trong một nhóm bệnh.
Những finding này có thể là:
quality/safety signals
chứ không phải:
payment findings.
Dr5 cần cho phép tách hai mục tiêu này.
31. Có thể có ba trục cảnh báo độc lập
Một event có thể có:
Payment risk
nguy cơ không đủ điều kiện thanh toán.
Quality risk
nguy cơ chất lượng điều trị.
Patient safety risk
nguy cơ an toàn người bệnh.
Ba trục không phải lúc nào cũng trùng nhau.
Một DVKT có thể:
được BHYT thanh toán
nhưng:
chưa chắc tối ưu về chuyên môn.
Ngược lại, một chỉ định chuyên môn hợp lý:
vẫn có thể ngoài phạm vi quỹ chi trả.
Đây là distinction bắt buộc.
32. Kết quả phân tích nên có mức độ tin cậy
Không nên mọi cảnh báo đều giống nhau.
Có thể phân:
Deterministic signal
Ví dụ arithmetic relation sai.
Strong analytic signal
Outlier lớn, lặp lại qua nhiều comparator.
Moderate signal
Có khác biệt nhưng case-mix chưa điều chỉnh đầy đủ.
Exploratory signal
Pattern mới, cần nghiên cứu thêm.
Confidence phải phản ánh:
chất lượng dữ liệu + độ mạnh association + completeness.
Không phản ánh:
mức tiền.
33. Phải tránh “AI hallucination” trong phân tích y khoa
Nếu dùng mô hình AI để phân tích narrative hoặc tìm pattern:
AI có thể hỗ trợ tìm candidate.
Nhưng không được tự tạo:
- chẩn đoán chưa có;
- chỉ định chưa có;
- kết quả chưa có;
- căn cứ pháp lý chưa tồn tại.
Mọi kết luận phải có:
provenance.
Nếu không có evidence:
kết quả phải giữ ở mức hypothesis.
34. Dr5 nên lưu “analysis provenance”
Một analytic finding nên biết:
- dataset nào;
- kỳ nào;
- version nào;
- population nào;
- denominator nào;
- comparator nào;
- algorithm/version nào;
- threshold nào;
- excluded records nào.
Nếu không:
vài tháng sau không thể tái tạo kết quả.
Đây là yêu cầu đặc biệt quan trọng với analytics.
35. Phân tích phải có reproducibility
Nếu dashboard hôm nay nói:
khoa A cao hơn 30%,
ngày mai cùng dữ liệu lại ra:
18%,
thì phải biết:
vì sao.
Có thể do:
- dataset được cập nhật;
- correction;
- comparator thay đổi;
- model version thay đổi.
Do đó analytics cần:
snapshot + version + parameter set.
36. Kết quả phân tích không nên trực tiếp tạo PAYMENT_CONDITION
Kiến trúc Dr5 phải giữ:
analytics layer
tách với:
rule/legal layer.
Analytics có thể tạo:
ANALYTIC_SIGNAL
hoặc mapping nội bộ tương đương WARN_REVIEW.
Sau đó nếu review xác định có một payment condition cụ thể:
mới chuyển sang rule engine dựa trên
dr5_payment_conditionvàdr5_legal_basis.
Không nên tạo:
“chi phí vượt percentile 95 → từ chối”.
37. Sáu catalog chuẩn vẫn được sử dụng, nhưng không bị lạm dụng
Analytics có thể sử dụng:
dr5_xml_fieldđể hiểu field;dr5_catalog_bindingđể normalize mã;dr5_xml_relationđể dựng relation;dr5_payment_conditionđể biết đâu là condition thật;dr5_legal_basisđể biết căn cứ và effective period.
Nhưng không cần tạo thêm:
dr5_outlier;dr5_cost_alert;dr5_frequency_analysis;dr5_provider_benchmark.
Các chỉ số phân tích thuộc:
analytics layer, không phải catalog pháp lý.
38. Pipeline phân tích phù hợp cho Dr5
Có thể tổ chức:
Raw XML
→ validate
→ normalize
→ resolve catalog version
→ deduplicate submissions
→ resolve patient/episode/event
→ construct analytic dataset
→ stratify/risk-adjust
→ calculate indicators
→ compare
→ detect signals
→ rank review candidates
→ retrieve source evidence
→ clinical/administrative review
→ classify root cause
→ improvement/action plan.
Điểm quan trọng nhất là:
signal detection không phải bước cuối.
39. Khi phát hiện bất thường, cần phân loại nguyên nhân
Một framework phù hợp có thể gồm:
Data cause
- lỗi mapping;
- thiếu dữ liệu;
- duplicate;
- version.
Population cause
- số người bệnh;
- age;
- disease mix;
- severity.
Price cause
- thay đổi giá;
- cơ cấu thuốc/VTYT.
Practice cause
- thay đổi tần suất chỉ định;
- thay đổi phác đồ;
- length of stay.
Organizational cause
- mở khoa;
- mở kỹ thuật;
- thay đổi tuyến nhận bệnh.
External cause
- dịch bệnh;
- chuyển tuyến;
- chính sách mới.
Potential inappropriate utilization
- chỉ xác định sau khi đã loại trừ các nguyên nhân hợp lý và rà soát hồ sơ.
40. Kết quả cuối cùng của phân tích nên dẫn đến hành động
Một analytic project chỉ tạo dashboard nhưng không có action:
giá trị rất hạn chế.
Sau rà soát có thể dẫn đến:
- không cần can thiệp;
- sửa dữ liệu;
- cập nhật danh mục;
- cải tiến quy trình;
- thay đổi cảnh báo CPOE;
- cập nhật clinical pathway;
- đào tạo;
- rà soát sử dụng thuốc;
- rà soát chỉ định;
- cải thiện discharge planning;
- hoàn thiện evidence;
- xây pre-adjudication rule.
Như vậy analytics trở thành:
learning loop.
41. Chương 7 không phải chương “tìm cách giảm chi bằng mọi giá”
Quản trị chi phí y tế không đồng nghĩa:
làm ít xét nghiệm hơn;
dùng thuốc rẻ hơn;
giảm ngày điều trị bằng mọi cách.
Mục tiêu phải là:
chi phí phù hợp với nhu cầu người bệnh, chất lượng điều trị và quy định thanh toán.
Nếu phân tích cho thấy một nhóm người bệnh đang:
thiếu dịch vụ cần thiết,
giải pháp đúng có thể làm:
chi phí tăng.
Nhưng đó vẫn là cải tiến chất lượng.
42. Chương 7 cũng không phải công cụ đánh giá cá nhân chỉ từ dữ liệu thô
Không nên dùng analytics đơn giản để:
- xếp hạng bác sĩ “tốt/xấu”;
- kết luận khoa lạm dụng;
- kết luận người bệnh bất hợp lý;
- kết luận sai phạm.
Dữ liệu nên được sử dụng để:
chọn đúng câu hỏi cần hỏi.
Không phải:
tự trả lời mọi câu hỏi.
43. Cấu trúc Chương 7
| Mã bài | Nội dung |
|---|---|
| 7.1 | XML cho biết được gì và chưa đủ để kết luận điều gì về chuyên môn khám chữa bệnh? |
| 7.2 | Phân tích quan hệ giữa chẩn đoán, thuốc và dịch vụ: dữ liệu cần có và giới hạn suy luận |
| 7.3 | Phân tích tần suất chỉ định, sử dụng thuốc, tái khám và thời gian điều trị |
| 7.4 | Phân tích cơ cấu chi phí theo bệnh, khoa, loại hình khám chữa bệnh và nhóm nguồn chi trả |
| 7.5 | Đọc cảnh báo chi phí tăng cao: lựa chọn nhóm so sánh và phân tích nguyên nhân thay đổi |
| 7.6 | Từ kết quả phân tích XML đến rà soát chuyên môn, cải tiến chất lượng và an toàn người bệnh |
44. Logic xuyên suốt của Chương 7
Có thể tóm tắt bằng chuỗi:
Dữ liệu
→ kiểm tra chất lượng
→ chuẩn hóa
→ xác định population
→ chọn denominator
→ chọn comparator
→ phân tích
→ phát hiện signal
→ xác định candidate cần rà soát
→ đối chiếu hồ sơ/tài liệu
→ phân tích nguyên nhân
→ kết luận phù hợp với mức bằng chứng
→ hành động cải tiến.
Không được rút ngắn thành:
outlier → sai phạm.
45. Ba câu hỏi phải luôn được đặt sau mọi biểu đồ
Khi một dashboard cho thấy một điểm bất thường, người đọc nên hỏi:
1. Dữ liệu có đủ tin cậy không?
Có thiếu, duplicate, sai version hoặc sai denominator không?
2. Nhóm so sánh có thực sự tương đồng không?
Có khác case-mix, mức độ nặng hoặc mô hình hoạt động không?
3. Cần thêm bằng chứng gì trước khi kết luận?
XML đủ chưa, hay phải xem HSBA/tài liệu nguồn?
Nếu chưa trả lời ba câu hỏi này:
chưa nên đưa ra kết luận chuyên môn.
46. Mục tiêu của Dr5 trong Chương 7
Ở các chương trước, Dr5 chủ yếu hoạt động như:
validation engine
và:
pre-adjudication engine.
Chương 7 mở thêm vai trò:
clinical and cost analytics platform.
Nhưng analytics của Dr5 phải có một đặc tính rất quan trọng:
explainable and conservative.
Hệ thống phải nói:
“Nhóm này khác nhóm so sánh 35%; nguyên nhân chưa xác định; đề nghị rà soát.”
thay vì:
“Nhóm này lạm dụng 35%.”
Kết luận
Dữ liệu XML tạo ra một nguồn thông tin rất lớn để hiểu hoạt động khám chữa bệnh và chi phí BHYT.
Nhưng giá trị của dữ liệu không nằm ở việc:
tạo càng nhiều cảnh báo càng tốt.
Giá trị nằm ở việc:
xác định đúng vấn đề cần xem xét, giảm số hồ sơ phải đọc thủ công và đưa người rà soát đến đúng bằng chứng cần kiểm tra.
Mười nguyên tắc cần giữ xuyên suốt Chương 7:
XML mô tả một phần quan trọng của hoạt động KCB nhưng không phải toàn bộ hồ sơ bệnh án.
Không có dữ liệu trong XML không đồng nghĩa sự kiện chuyên môn không xảy ra.
Association không chứng minh causation và không tự động tạo payment condition.
Data quality phải được kiểm tra trước analytics.
Frequency phải được tính trên business event sau khi deduplicate, không đơn giản trên số dòng XML.
Mọi tỷ lệ phải có denominator và cửa sổ thời gian rõ ràng.
Outlier phụ thuộc comparator, case-mix, thời gian và bối cảnh; outlier là candidate để rà soát chứ không phải kết luận sai phạm.
Điều 11 đặt phân tích dữ liệu trước bước xác định hồ sơ cần rà soát và đối chiếu trực tiếp với hồ sơ, tài liệu.
Điều 13 xác định chi phí tăng cao là cảnh báo yêu cầu cơ sở phân tích nguyên nhân chủ quan và khách quan, không mặc nhiên là chi phí không được thanh toán.
Kết quả phân tích phải dẫn đến rà soát, cải tiến chất lượng, an toàn người bệnh và quản trị chi phí; chỉ khi có căn cứ thanh toán cụ thể và đủ bằng chứng mới được chuyển thành kết luận về thanh toán.
Đối với Dr5-XML, Chương 7 mở rộng hệ thống từ:
“hồ sơ này có lỗi gì?”
sang:
“toàn bộ dữ liệu đang cho thấy điều gì đáng quan tâm?”
Nhưng nguyên tắc bảo vệ khỏi false positive vẫn không thay đổi:
Data signal
→ Review candidate
→ Evidence
→ Context
→ Conclusion.
Không phải:
Data signal
→ Denial.
Nếu giữ được ranh giới này, dữ liệu XML có thể được sử dụng đồng thời cho ba mục tiêu:
giảm nguy cơ thanh toán;
quản trị sử dụng nguồn lực;
cải tiến chất lượng và an toàn người bệnh.
Đó cũng là bước chuyển từ một hệ thống kiểm tra hồ sơ BHYT sang một nền tảng phân tích hoạt động khám chữa bệnh dựa trên dữ liệu nhưng vẫn tôn trọng giới hạn của dữ liệu và vai trò của đánh giá chuyên môn.
- Đăng nhập để gửi ý kiến