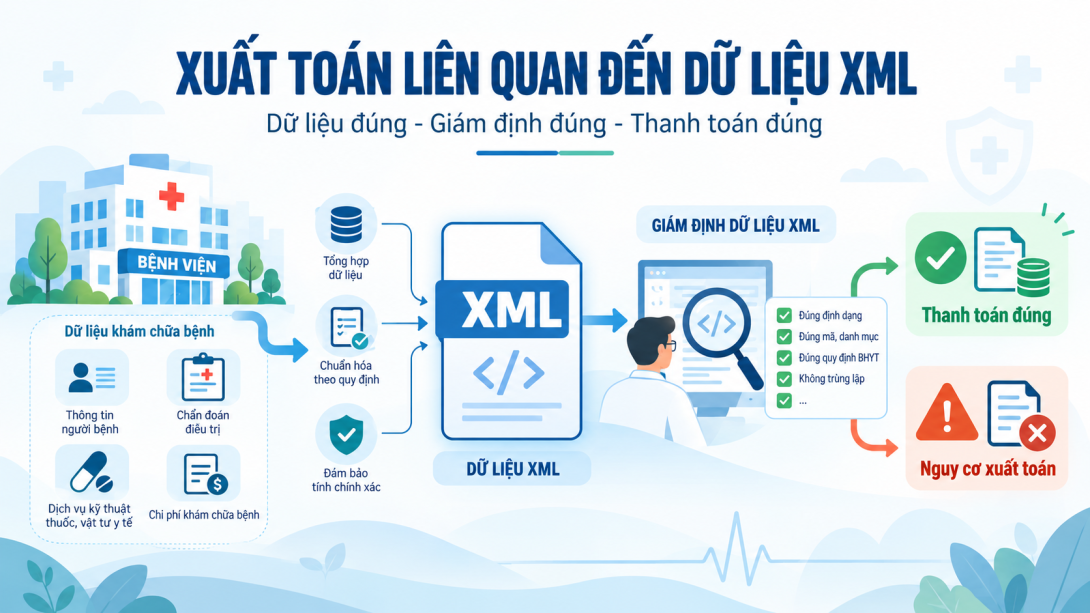
Sau khi dữ liệu đã đúng cấu trúc, requiredness và danh mục, hệ thống vẫn phải trả lời một câu hỏi quan trọng:
Các record này có thực sự thuộc đúng người bệnh, đúng đợt KCB và liên kết đúng với nhau hay không?
Một file XML có thể chứa toàn bộ mã hợp lệ nhưng vẫn sai nếu:
- một đợt KCB bị gửi thành hai hồ sơ;
- cùng một dòng thuốc hoặc DVKT bị nhân đôi;
- XML2/XML3 tham chiếu
MA_LKkhông tồn tại trong XML1; - XML4 có kết quả nhưng không tìm được DVKT tương ứng;
- dữ liệu của hai đợt KCB bị gộp nhầm;
- cùng
MA_LKnhưng các thông tin định danh nền tảng mâu thuẫn.
Chuẩn dữ liệu xác định MA_LK là mã đợt điều trị duy nhất, dùng để liên kết Bảng XML1 với các bảng còn lại trong một lần KCB. STT được mô tả là số thứ tự tăng từ 1 đến hết trong một lần gửi dữ liệu.
Điều 10 Thông tư 12/2026/TT-BTC đồng thời đưa “số liệu thống nhất trên Bảng kê chi tiết” vào nội dung giám định tự động.
Nguyên tắc của Bài 4.4 là:
Định danh đúng phải xác định được record thuộc đợt KCB nào; liên kết đúng phải chứng minh được các record chi tiết có bản ghi cha và quan hệ nghiệp vụ tương ứng.
1. Phải phân biệt người bệnh, đợt KCB và dòng dữ liệu
Ba cấp này không giống nhau.
Người bệnh
Có thể được nhận diện bởi các thông tin như:
MA_BN;- họ tên;
- ngày sinh;
- thông tin định danh;
- mã thẻ BHYT.
Một người bệnh có thể có nhiều đợt KCB.
Đợt KCB
Được liên kết chủ yếu bằng:
MA_LK.
Dòng dữ liệu
Một đợt KCB có thể có:
- nhiều thuốc XML2;
- nhiều DVKT/VTYT XML3;
- nhiều chỉ số kết quả XML4;
- nhiều diễn biến XML5.
Do đó:
một người ≠ một MA_LK ≠ một dòng XML.
Nếu không phân biệt ba cấp này, rule duplicate rất dễ sai.
2. MA_LK là trục liên kết của đợt KCB
Chuẩn mô tả MA_LK là mã đợt điều trị duy nhất, dùng để liên kết XML1 với các bảng còn lại trong cùng một lần KCB. Cách diễn giải này được lặp lại ở XML2, XML3, XML4 và nhiều bảng khác.
Do đó cấu trúc cơ bản là:
XML1.MA_LK ← XML2.MA_LK
XML1.MA_LK ← XML3.MA_LK
XML1.MA_LK ← XML4.MA_LK
XML1.MA_LK ← XML5.MA_LK
...
Có thể coi XML1 là record tổng hợp cha của một đợt KCB.
3. Không được hiểu MA_LK là khóa duy nhất của từng dòng chi tiết
Trong phần diễn giải, MA_LK được ghi kèm thuật ngữ “PRIMARY KEY”. Tuy nhiên ở các bảng chi tiết, một đợt KCB rõ ràng có thể có nhiều dòng cùng MA_LK:
- nhiều thuốc;
- nhiều DVKT;
- nhiều vật tư;
- nhiều kết quả;
- nhiều diễn biến.
Vì vậy về thiết kế kiểm tra:
không thể dùng
MA_LKmột mình để xác định uniqueness của dòng XML2/XML3/XML4/XML5.
MA_LK phải được hiểu chủ yếu là episode linkage key.
Nếu rule đặt:
XML2.MA_LK must be unique
thì hầu hết hồ sơ có từ hai thuốc trở lên sẽ bị báo sai.
4. STT cũng không phải khóa duy nhất toàn hệ thống
Chuẩn quy định STT là số thứ tự tăng từ 1 đến hết trong một lần gửi dữ liệu.
Điều đó không cho phép suy ra:
STT = 1trên XML2
và:
STT = 1trên XML3
là cùng một đối tượng.
Cũng không nên mặc định STT là định danh bất biến qua:
- các lần kết xuất;
- các version;
- các lần gửi lại.
Do đó STT có giá trị chủ yếu trong phạm vi bảng/lần gửi tương ứng.
5. Hồ sơ trùng phải được phát hiện ở cấp đợt KCB
Trường hợp rõ nhất:
trong XML1 xuất hiện hai record cùng
MA_LK.
Nếu chuẩn yêu cầu một MA_LK đại diện duy nhất cho một đợt KCB, đây là dấu hiệu mạnh của duplicate.
Nhưng vẫn cần phân biệt:
Duplicate thực sự
Cùng một đợt KCB bị kết xuất hai lần trong cùng package.
Hai version giao dịch
Cùng đợt KCB được gửi lại sau điều chỉnh.
Trường hợp thứ hai không phải duplicate dữ liệu nếu hệ thống versioning quản lý đúng.
Do đó duplicate detection phải biết thêm:
submission_id;version_id;- mục đích gửi.
6. Hai MA_LK khác nhau vẫn có thể là cùng một đợt bị tách nhầm
Đây là loại duplicate khó hơn.
Ví dụ có hai hồ sơ:
- cùng người bệnh;
- cùng thời điểm vào;
- cùng thời điểm ra;
- cùng khoa;
- cùng chẩn đoán;
- gần như toàn bộ chi phí giống nhau;
nhưng MA_LK khác nhau.
Không thể tự động kết luận chắc chắn rằng đó là hồ sơ trùng, vì người bệnh có thể có hai lượt KCB gần nhau.
Phù hợp hơn là:
WARN_REVIEW
với duplicate score hoặc candidate matching.
7. Không nên phát hiện hồ sơ trùng chỉ bằng họ tên
Hai người có thể:
- cùng họ tên;
- cùng năm sinh;
- thậm chí cùng ngày sinh.
Ngược lại, cùng một người có thể thay đổi:
- mã thẻ;
- thông tin địa chỉ;
- cách ghi họ tên.
Do đó deduplication nên kết hợp nhiều thuộc tính:
định danh + thời gian KCB + cơ sở + episode characteristics.
Không nên tạo rule:
same HO_TEN → duplicate.
8. Dòng trùng khó hơn hồ sơ trùng
Trong XML2, người bệnh có thể hợp lệ nhận cùng một thuốc:
- nhiều lần;
- nhiều ngày;
- nhiều y lệnh;
- ở nhiều khoa;
- với số lượng khác nhau.
Trong XML3, cùng một mã DVKT có thể được thực hiện:
- nhiều lần;
- hai bên cơ thể;
- tại nhiều thời điểm;
- bởi các người thực hiện khác nhau.
Vì vậy:
cùng
MA_LK + MA_THUOCchưa đủ để kết luận dòng thuốc trùng.
Tương tự:
cùng
MA_LK + MA_DICH_VUchưa đủ để kết luận DVKT trùng.
9. Duplicate line phải được xác định bằng “business identity”
Một candidate duplicate XML2 có thể cần xét đồng thời:
MA_LK;MA_THUOC;NGAY_YL;NGAY_TH_YL;MA_KHOA;MA_BAC_SI;SO_LUONG;DON_GIA;- thông tin thầu.
Với XML3 có thể xét:
MA_LK;MA_DICH_VU;MA_VAT_TU;NGAY_YL;NGAY_TH_YL;MA_KHOA;NGUOI_THUC_HIEN;SO_LUONG;DON_GIA_BH.
Không có nghĩa đây là các khóa pháp lý chính thức.
Đó là tập thuộc tính phục vụ duplicate candidate detection.
10. Hai dòng giống hệt nhau chưa chắc luôn là sai
Ví dụ một thuốc được cấp hai lần nhưng HIS tổng hợp không phân biệt được đủ timestamp.
Hoặc một xét nghiệm được thực hiện hai lần cùng ngày.
Do đó khi phát hiện hai dòng hoàn toàn giống nhau, Dr5 nên hỏi:
Có hai sự kiện nguồn thực sự hay một record bị nhân đôi?
Nếu XML không đủ thông tin để kết luận, phù hợp hơn là:
WARN_REVIEW
và đối chiếu HIS/y lệnh/pharmacy.
Chỉ khi dữ liệu nguồn chứng minh một sự kiện nhưng XML xuất hiện hai lần mới có cơ sở mạnh để kết luận duplicate.
11. Chi tiết không có XML1 là orphan record
Đây là loại lỗi liên kết quan trọng.
Ví dụ XML2 có:
MA_LK = A123
nhưng XML1 không có:
MA_LK = A123.
Khi đó dòng thuốc không xác định được hồ sơ tổng hợp cha.
Đây là:
ORPHAN CHILD RECORD.
Tương tự với XML3, XML4, XML5 và các bảng chuyên biệt.
Về cấu trúc quan hệ:
child.MA_LK must resolve to one applicable XML1 episode.
Nếu không resolve được, đây thường là lỗi kỹ thuật/quan hệ có độ chắc chắn cao.
12. Một chi tiết liên kết tới nhiều XML1 cũng là lỗi nghiêm trọng
Nếu package có hai XML1 cùng MA_LK = A123, một dòng XML3 mang A123 sẽ không còn biết thuộc record tổng hợp nào.
Đây là vấn đề:
non-unique parent resolution.
Do đó phải kiểm tra theo thứ tự:
- uniqueness của XML1;
- sau đó mới resolve các bảng con.
Nếu parent đã không duy nhất, các quan hệ downstream trở nên không đáng tin cậy.
13. Mất liên kết không chỉ xảy ra ở MA_LK
Một số quan hệ nghiệp vụ cần nhiều hơn episode linkage.
Ví dụ XML4 chứa:
MA_LK;MA_DICH_VU;MA_CHI_SO.
Chuẩn chỉ yêu cầu gửi XML4 khi người bệnh có thực hiện dịch vụ cận lâm sàng.
Nếu XML4 có kết quả xét nghiệm nhưng XML3 không tìm thấy dịch vụ CLS tương ứng, cần đặt câu hỏi:
kết quả này phát sinh từ dịch vụ nào?
Đây là dạng:
cross-table orphan relationship.
14. Có XML3 nhưng không có XML4 chưa chắc là lỗi
Chiều ngược lại phải thận trọng.
Không phải mọi dòng XML3 đều phải có XML4.
XML3 còn chứa:
- khám bệnh;
- giường;
- VTYT;
- nhiều loại DVKT khác.
XML4 chỉ áp dụng cho dịch vụ cận lâm sàng theo điều kiện tương ứng.
Do đó không được viết:
every XML3 row must have XML4.
Phải lọc candidate trước:
XML3 row thuộc loại CLS cần kết quả → kiểm tra XML4.
Đây là nguyên tắc quan trọng của CatalogCandidateResolver.
15. Quan hệ chi tiết phải được kiểm tra theo đúng chiều
Có hai loại kiểm tra khác nhau:
Parent → child expectation
Ví dụ một sự kiện lâm sàng nhất định có thể được kỳ vọng có record chi tiết.
Child → parent existence
Ví dụ XML4 đã tồn tại thì phải tìm được episode và dịch vụ nguồn phù hợp.
Chiều thứ hai thường có độ chắc chắn cao hơn.
Vì:
có child mà không có parent
là bất nhất rõ ràng hơn:
có parent nhưng chưa thấy child
vốn còn phụ thuộc requiredness.
16. Bảng chuyên biệt cũng phải gắn đúng đợt KCB
Nhiều bảng chuyên biệt tiếp tục sử dụng MA_LK để liên kết với XML1.
Ví dụ Bảng 6 HIV/AIDS sử dụng MA_LK theo cùng nguyên tắc.
Bảng tóm tắt hồ sơ bệnh án và các chứng từ liên quan cũng có điều kiện áp dụng riêng; chẳng hạn Bảng 8 chỉ được gửi cho những hình thức điều trị nhất định.
Do đó cần kiểm tra đồng thời:
link exists + table applicable.
Một bảng có MA_LK hợp lệ nhưng xuất hiện trong một hồ sơ không thuộc điều kiện áp dụng vẫn có thể là dữ liệu bất thường.
17. Không được gộp hai đợt điều trị chỉ vì cùng người bệnh
Một bệnh nhân có thể:
- khám sáng;
- quay lại cấp cứu tối;
- tái khám sau vài ngày;
- điều trị ngoại trú nhiều đợt.
Các lần này có thể là các episode khác nhau.
Do đó quan hệ:
same MA_BN
không cho phép:
same MA_LK.
Ngược lại nếu hệ thống dùng một MA_LK kéo dài qua các sự kiện vốn phải tách thành các đợt riêng, các thuốc, DVKT và chi phí có thể bị trộn.
Đây là dạng:
episode boundary error.
18. Kiểm tra consistency của định danh nền
Trong cùng một MA_LK, các dữ liệu nền không nên mâu thuẫn vô lý.
Ví dụ:
- XML1 nói một mã cơ sở;
- chứng từ liên quan lại biểu diễn thông tin người bệnh hoàn toàn khác;
- một bảng con được gắn vào
MA_LKcủa người khác.
Các bảng chuyên biệt thường tái sử dụng thông tin từ XML1. Vì vậy có thể kiểm tra:
ATTRIBUTE_CONSISTENCY across records sharing MA_LK.
Tuy nhiên phải căn cứ diễn giải field cụ thể; không được yêu cầu mọi field lặp lại phải giống tuyệt đối nếu chuẩn cho phép khác biệt.
19. STT cần được kiểm tra trong đúng phạm vi
Vì STT được mô tả là số thứ tự tăng từ 1 đến hết trong một lần gửi dữ liệu, có thể kiểm tra:
- có phải số;
- có trùng bất thường trong phạm vi thích hợp;
- có thứ tự không hợp lý.
Nhưng không nên dùng STT để liên kết nghiệp vụ xuyên bảng nếu chuẩn không quy định.
Ví dụ:
XML2.STT = 5
không có nghĩa liên quan đến:
XML3.STT = 5.
STT là sequencing identifier, không phải universal foreign key.
20. Cần phân biệt duplicate dữ liệu và duplicate giao dịch
Một hồ sơ có thể được gửi:
- lần đầu;
- gửi lại do timeout;
- gửi version điều chỉnh.
Nếu chỉ đọc kho lưu trữ transaction, có thể thấy cùng MA_LK nhiều lần.
Điều đó không nhất thiết là hồ sơ trùng.
Phải xét:
episode_id + version_id + submission_id + hash.
Ví dụ:
V1/S1
Đã gửi và được tiếp nhận.
V2/S2
Version điều chỉnh.
Đây là lịch sử hợp lệ.
Trong khi:
V1/S1
V1/S2
cùng nội dung được gửi hai lần ngoài ý muốn có thể là duplicate transaction.
Bài 3.6 đã xử lý lớp vấn đề này.
21. Kiểm tra liên kết phải hỗ trợ trạng thái “không chắc chắn”
Giả sử XML4 có một kết quả và tìm thấy hai dòng XML3 cùng:
MA_LK;MA_DICH_VU;- thời gian gần nhau.
Nếu không có đủ thông tin để biết kết quả thuộc lần thực hiện nào, không nên tự chọn một dòng.
Kết quả đúng là:
AMBIGUOUS_RELATIONSHIP
và phân loại:
WARN_REVIEWhoặcINFO_EVIDENCE.
Đây tốt hơn nhiều so với silently join vào candidate đầu tiên.
22. Không được dùng fuzzy matching để tạo liên kết chắc chắn
Fuzzy matching có thể dùng để:
tìm candidate.
Nhưng không nên dùng:
“90% giống nhau → coi là cùng record”
để đưa ra kết luận thanh toán tự động.
Đối với quan hệ BHYT, cần phân biệt:
- deterministic join;
- candidate join;
- unresolved join.
Nếu không, hệ thống có thể gắn nhầm chi phí của hai sự kiện khác nhau.
23. Trùng dòng có thể làm sai toàn bộ phép tính tổng hợp
Nếu một dòng XML3 bị nhân đôi:
- số lượng có thể tăng;
THANH_TIEN_BVtăng;THANH_TIEN_BHtăng;- tổng XML1 cũng có thể tăng nếu exporter tính từ dữ liệu đã trùng.
Khi đó phép kiểm:
tổng XML1 = tổng XML2/XML3
vẫn có thể đúng về số học.
Nhưng hồ sơ vẫn sai vì dữ liệu nguồn bị duplicate.
Điều này cho thấy:
arithmetic consistency không thay thế duplicate detection.
24. Ngược lại, mất dòng có thể vẫn không bị phát hiện bằng kiểm tra khóa
Một dòng DVKT có trong HIS nhưng bị bỏ khi export XML.
Các record XML còn lại đều liên kết đúng.
Không có orphan.
Không có duplicate.
Nhưng XML vẫn thiếu dữ liệu so với nguồn.
Loại lỗi này chỉ được phát hiện ở Bài 4.8:
XML ↔ HIS/HSBA/bảng kê.
Do đó Bài 4.4 kiểm tra internal referential integrity, không thay thế source reconciliation.
25. Trách nhiệm về tính khớp đúng vượt ra ngoài XML
Khoản 2 Điều 5 Thông tư 12 yêu cầu cơ sở KCB chịu trách nhiệm về tính trung thực, chính xác và khớp đúng giữa Bảng kê chi tiết, Bảng tổng hợp, Báo cáo quyết toán với hồ sơ bệnh án.
Vì vậy một quan hệ XML nội bộ hoàn hảo vẫn chưa đủ.
Mục tiêu của Bài này chỉ là xác lập:
cấu trúc định danh và quan hệ bên trong dữ liệu có nhất quán hay không.
26. Ma trận kiểm tra định danh và liên kết
| Tình huống | Nhận định ban đầu |
|---|---|
XML1 có hai dòng cùng MA_LK trong cùng version/package | ERROR_TECH |
XML2 có MA_LK không tồn tại XML1 | ERROR_TECH |
XML3 có MA_LK không tồn tại XML1 | ERROR_TECH |
XML4 có MA_LK không tồn tại XML1 | ERROR_TECH |
| XML4 không tìm được DVKT CLS nguồn phù hợp | WARN_REVIEW / INFO_EVIDENCE tùy khả năng resolve |
hai XML2 cùng MA_THUOC nhưng khác thời gian | chưa đủ kết luận duplicate |
| hai XML3 giống hoàn toàn mọi thuộc tính chính | duplicate candidate |
cùng bệnh nhân có hai MA_LK gần như trùng toàn bộ episode | WARN_REVIEW |
cùng STT ở hai bảng khác nhau | không mặc định lỗi |
cùng MA_LK xuất hiện ở hai version gửi khác nhau | không mặc định duplicate |
| child match được hai parent/candidate | ambiguous relationship |
27. Kiến trúc Dr5-XML
Các quan hệ này nên được mô hình hóa chủ yếu trong:
dr5_xml_field
Xác định:
- field định danh;
- field sequencing;
- field tham gia liên kết.
dr5_xml_relation
Quản lý các quan hệ như:
- XML2 → XML1;
- XML3 → XML1;
- XML4 → XML1;
- XML4 → XML3;
- chứng từ → episode;
- các quan hệ cross-table khác.
Các relation có thể sử dụng những loại logic như:
CROSS_TABLE_RECONCILIATION;CONDITIONAL_REFERENCE;ATTRIBUTE_CONSISTENCY.
Không cần tạo bảng riêng kiểu:
dr5_xml_key;dr5_episode_link;dr5_service_result_link.
Mục tiêu vẫn là duy trì kiến trúc generic.
28. Generic implementation nên tách các loại kiểm tra
Có thể có các implementation tổng quát:
unique_record;duplicate_candidate;parent_exists;reference_resolves;reference_resolves_unique;conditional_reference;attribute_consistency;orphan_record;sequence_integrity.
Rule definition mới quyết định:
- bảng nguồn;
- bảng đích;
- join fields;
- candidate filters;
- cardinality mong đợi.
Nhờ vậy cùng một engine có thể kiểm tra nhiều quan hệ XML mà không viết code riêng cho từng bảng.
29. Cardinality phải được khai báo rõ
Một quan hệ có thể là:
1 → 1
Một episode → một XML1.
1 → N
Một XML1 → nhiều XML2.
1 → N
Một XML1 → nhiều XML3.
N → 1 hoặc N → N theo ngữ cảnh
Một số kết quả/chi tiết có thể cần resolver phức tạp hơn.
Không nên mặc định:
mọi relation là 1 → 1.
Đây là nguyên nhân phổ biến tạo false positive trong cross-table validation.
30. Phân loại finding
ERROR_TECH
Phù hợp khi:
- parent bắt buộc không tồn tại;
- XML1 duplicate
MA_LKtrong cùng phạm vi; - relation bắt buộc không thể resolve do lỗi dữ liệu rõ ràng.
WARN_REVIEW
Khi:
- nghi duplicate nhưng có thể là hai sự kiện thật;
- quan hệ có nhiều candidate;
- episode có dấu hiệu bị tách/gộp sai.
INFO_EVIDENCE
Khi cần HIS/EMR/pharmacy/LIS để xác định quan hệ thực tế.
PAYMENT_CONDITION
Chỉ khi việc sai liên kết đồng thời chứng minh vi phạm điều kiện thanh toán cụ thể.
Duplicate candidate không nên tự động đồng nghĩa xuất toán.
Kết luận
Kiểm tra định danh và liên kết nhằm bảo đảm dữ liệu XML không chỉ gồm các dòng “đúng riêng lẻ”, mà còn tạo thành một hồ sơ có cấu trúc quan hệ đúng.
Chuỗi kiểm tra nên là:
xác định episode
→ kiểm tra uniqueness XML1
→ resolve các bảng con theo MA_LK
→ phát hiện orphan
→ xác định business identity của từng dòng
→ phát hiện duplicate candidate
→ kiểm tra các quan hệ sâu hơn giữa dịch vụ, kết quả và chứng từ.
Sáu nguyên tắc quan trọng cần nhớ:
MA_LKlà trục liên kết đợt KCB, không phải khóa duy nhất của mọi dòng chi tiết.
STTlà số thứ tự trong phạm vi lần gửi/bảng tương ứng, không phải khóa liên kết toàn bộ hệ thống.
Cùng mã thuốc hoặc dịch vụ chưa đủ để kết luận dòng trùng.
Chi tiết có
MA_LKkhông tồn tại trong XML1 là dấu hiệu orphan có độ chắc chắn cao.
Quan hệ không resolve được và quan hệ có nhiều candidate là hai loại lỗi khác nhau.
Internal consistency của XML không thay thế việc đối chiếu với HIS và hồ sơ bệnh án.
Đối với Dr5-XML, Bài 4.4 là nền tảng của record_relationship và các rule cross-table: thay vì hard-code từng phép join, hệ thống cần một generic relationship engine biết nguồn, đích, điều kiện join, cardinality và cách xử lý trường hợp không tìm thấy hoặc tìm thấy nhiều candidate. Đây là bước cần thiết trước khi kiểm tra sâu hơn về thứ tự thời gian ở Bài 4.5 và đối chiếu liên bảng ở Bài 4.7.
- Đăng nhập để gửi ý kiến