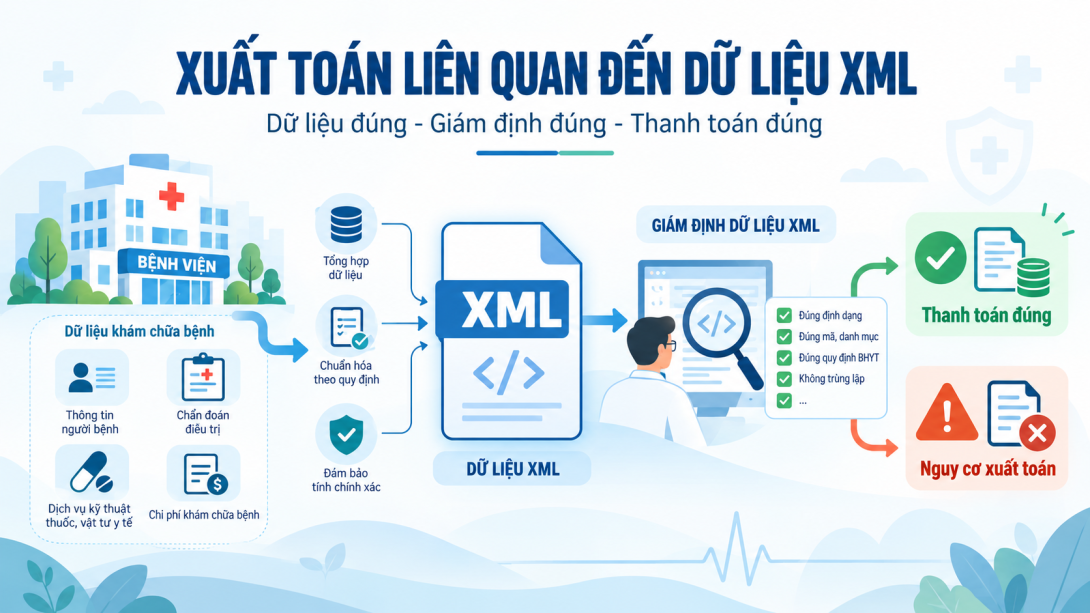
Dữ liệu XML phục vụ quản lý và thanh toán BHYT không chỉ là một tập hợp các trường kỹ thuật. Trong một hồ sơ XML có thể tồn tại thông tin định danh người bệnh, thời gian khám chữa bệnh, chẩn đoán, thuốc, dịch vụ kỹ thuật, vật tư y tế, chi phí, người hành nghề và nhiều thông tin khác có khả năng phản ánh tình trạng sức khỏe và quá trình điều trị. Vì vậy một file XML được tải xuống máy tính cá nhân, sao chép sang USB, gửi qua email, đưa vào môi trường phát triển hoặc sử dụng trong đào tạo không đơn giản là một thao tác kỹ thuật; đó là việc tạo thêm một bản sao dữ liệu người bệnh ngoài vị trí ban đầu và làm thay đổi phạm vi kiểm soát của bệnh viện.
Thông tư 12/2026/TT-BTC quy định cơ sở KCB phải chịu trách nhiệm quản lý, sử dụng tài khoản quản trị, phân quyền các tài khoản giao dịch đã tạo lập đúng mục đích, không sử dụng chung tài khoản, đồng thời bảo đảm an toàn thông tin và bảo vệ thông tin cá nhân của người bệnh theo quy định của pháp luật. Đây là căn cứ trực tiếp quan trọng đối với Chương 9, bởi trách nhiệm bảo mật không chỉ đặt ở hệ thống của cơ quan BHXH mà còn đặt ngay tại cơ sở KCB trong quá trình quản lý và sử dụng dữ liệu.
Tuy nhiên, Thông tư 12 không quy định chi tiết bệnh viện phải sử dụng một mô hình RBAC cụ thể, một thuật toán mã hóa cụ thể, một sản phẩm DLP cụ thể hay một phương thức khử định danh duy nhất. Những biện pháp kỹ thuật và quản trị được trình bày trong bài này là đề xuất triển khai nội bộ nhằm giúp bệnh viện thực hiện nguyên tắc phân quyền, an toàn thông tin và bảo vệ thông tin cá nhân phù hợp với hoạt động thực tế.
Nguyên tắc trung tâm của Bài 9.3 là:
Dữ liệu XML chỉ được truy cập, sao chép, lưu trữ, chia sẻ và tái sử dụng trong phạm vi cần thiết cho một mục đích hợp lệ; khi dữ liệu rời khỏi môi trường nguồn, mức kiểm soát không được giảm xuống chỉ vì nó đã được chuyển thành file.
1. Bảo mật dữ liệu XML phải được nhìn theo toàn bộ vòng đời
Không thể bảo mật XML chỉ bằng cách bảo vệ thư mục chứa file cuối cùng. Dữ liệu đi qua nhiều trạng thái:
được tạo trong hệ thống nguồn;
được tổng hợp;
kết xuất thành XML;
kiểm tra;
ký;
gửi;
lưu phản hồi;
điều chỉnh;
gửi lại;
lưu trữ;
phân tích;
sử dụng cho kiểm thử hoặc đào tạo.
Mỗi lần chuyển trạng thái đều có thể tạo thêm:
bản sao;
tài khoản truy cập;
đường truyền;
hoặc vị trí lưu trữ.
Do đó bảo mật cần được thiết kế theo:
data lifecycle
chứ không theo:
một server duy nhất.
2. Ba mục tiêu kỹ thuật quan trọng
Có thể sử dụng ba thuộc tính kinh điển của an toàn thông tin để thiết kế hệ thống.
Confidentiality
Chỉ người có quyền và mục đích phù hợp mới được xem dữ liệu.
Integrity
Dữ liệu không bị thay đổi trái phép hoặc không để lại dấu vết.
Availability
Dữ liệu và bằng chứng vẫn có thể được truy xuất khi cần cho hoạt động KCB, thanh toán, giải trình hoặc audit.
Đây là framework kỹ thuật chung để quản trị an toàn thông tin; không nên hiểu rằng ba thuật ngữ này được Thông tư 12 định nghĩa trực tiếp tại điều khoản nêu trên.
3. Với Dr5 cần bổ sung thêm accountability
Ngoài confidentiality, integrity và availability, hệ thống còn cần trả lời:
ai đã làm gì với dữ liệu?
Nếu một XML được tải xuống, một rule bị override hoặc một record được sửa nhưng không xác định được người thực hiện thì cả bảo mật và quản trị chất lượng đều suy yếu.
Điều này liên hệ trực tiếp với yêu cầu:
không sử dụng chung tài khoản.
4. Phân quyền phải theo nhiệm vụ, không theo sự thuận tiện
Một mô hình yếu thường tạo một tài khoản hoặc role:
“XML”
và cấp quyền xem toàn bộ dữ liệu cho tất cả những ai có liên quan.
Mô hình phù hợp hơn là:
role-based access theo chức năng thực tế.
Ví dụ:
- nhân viên BHYT cần xem dữ liệu phục vụ thanh toán;
- bác sĩ cần xem hồ sơ thuộc trách nhiệm chuyên môn;
- Dược cần dữ liệu thuốc;
- kế toán cần số liệu tài chính;
- CNTT cần metadata và quyền kỹ thuật cần thiết để vận hành.
Không phải tất cả đều cần:
toàn bộ nội dung XML.
5. Least privilege nên là nguyên tắc mặc định
Mỗi tài khoản chỉ nên có:
quyền tối thiểu cần thiết để thực hiện nhiệm vụ.
Nếu nhân viên chỉ cần:
xem finding,
không cần quyền:
export toàn bộ XML.
Nếu chỉ cần:
quản trị catalog,
không nhất thiết được xem:
toàn bộ dữ liệu người bệnh.
Least privilege vừa giảm nguy cơ lộ dữ liệu vừa giảm nguy cơ:
chỉnh sửa nhầm.
6. Quyền xem, sửa, phê duyệt và xuất dữ liệu phải tách nhau
Một user có thể được phép:
xem hồ sơ
nhưng không được:
sửa.
Một user khác có quyền:
sửa
nhưng không được:
phê duyệt correction rủi ro cao.
Một người có thể xem dữ liệu trong giao diện nhưng:
không được bulk export.
Vì vậy permission model nên phân biệt ít nhất:
- VIEW;
- EDIT;
- APPROVE;
- OVERRIDE;
- EXPORT;
- ADMINISTER.
7. Quyền export cần được kiểm soát chặt hơn quyền xem
Xem một hồ sơ trên hệ thống và tải 100.000 hồ sơ về laptop là hai mức rủi ro hoàn toàn khác nhau.
Bulk export làm dữ liệu:
rời khỏi boundary của ứng dụng;
khó thu hồi;
dễ sao chép tiếp;
khó kiểm soát retention.
Do đó không nên coi:
quyền xem = quyền tải xuống.
8. Không sử dụng chung tài khoản
Thông tư 12 quy định trực tiếp cơ sở phải quản lý và phân quyền tài khoản đúng mục đích, không sử dụng chung tài khoản.
Với Dr5, điều này đặc biệt quan trọng vì hệ thống cần truy được:
- ai xem dữ liệu;
- ai sửa;
- ai export;
- ai override;
- ai phê duyệt.
Tài khoản dùng chung làm mất:
accountability.
9. Tài khoản cá nhân phải được thu hồi khi không còn nhu cầu
Khi nhân viên:
- chuyển khoa;
- thay nhiệm vụ;
- nghỉ việc;
quyền truy cập cũ phải được:
rà soát và thu hồi.
Không nên chỉ thêm quyền mới mà không bao giờ:
dọn quyền cũ.
10. Phân quyền cần được rà soát định kỳ
Ngay cả khi quyền ban đầu đúng, sau một thời gian:
- cơ cấu thay đổi;
- workflow thay đổi;
- nhân viên đổi vị trí.
Vì vậy access review định kỳ là một biện pháp quản trị phù hợp.
Chu kỳ cụ thể do bệnh viện xác định theo:
mức rủi ro và khả năng quản trị.
11. Tài khoản đặc quyền phải được kiểm soát riêng
Các tài khoản:
- administrator;
- DBA;
- system/root;
có thể vượt qua các giới hạn của ứng dụng.
Do đó cần:
- hạn chế số người sử dụng;
- log truy cập;
- không dùng tài khoản đặc quyền cho công việc thường ngày.
Có quyền kỹ thuật cao không đồng nghĩa:
được phép xem hoặc chỉnh mọi dữ liệu vì mục đích bất kỳ.
12. Truy cập kỹ thuật cần có mục đích
Một quản trị viên có thể cần đọc database để:
điều tra lỗi.
Nhưng điều đó không có nghĩa được phép:
trích dữ liệu bệnh nhân cho mục đích cá nhân.
Technical access vẫn phải:
purpose-limited.
13. Cần phân biệt quyền đối với dữ liệu hiện tại và dữ liệu lưu trữ
Một nhân viên có thể cần xem hồ sơ đang xử lý nhưng không cần:
truy cập toàn bộ archive nhiều năm.
Historical data có thể được quản lý:
ở scope khác.
Điều này giảm:
phạm vi exposure.
14. Mỗi bản sao XML đều là một tài sản cần quản lý
Một file:
hoso.xml
trên desktop không “vô hại” chỉ vì là file text.
Nó có thể chứa:
nhiều trường dữ liệu nhạy cảm.
Do đó nguyên tắc phù hợp là:
copy phải có lý do.
15. Không nên tải file xuống máy cá nhân nếu công việc có thể thực hiện trong hệ thống
Nếu người dùng có thể:
xem, lọc, đối chiếu
trực tiếp trên Dr5,
không cần:
export.
Giảm số bản sao là một trong những biện pháp bảo mật hiệu quả nhất.
16. Export phải theo nguyên tắc data minimization
Nếu mục tiêu chỉ cần:
MA_LK + finding + amount,
không nên xuất:
toàn bộ XML với đầy đủ thông tin bệnh nhân.
Nên export:
đúng tập dữ liệu cần cho nhiệm vụ.
17. Bulk export nên có audit
Một hành động xuất dữ liệu lớn nên lưu:
- user;
- timestamp;
- mục đích nếu policy yêu cầu;
- loại dữ liệu;
- số record;
- file/output identifier.
Điều này giúp:
điều tra khi có incident.
18. Có thể áp dụng approval cho export rủi ro cao
Không phải mọi file Excel đều cần phê duyệt. Tuy nhiên việc xuất:
toàn bộ XML một năm
khác với:
một báo cáo tổng hợp 20 dòng.
Bệnh viện có thể áp dụng:
risk-based export approval.
19. File export nên có thời hạn sử dụng phù hợp
Một file được tạo phục vụ một cuộc họp không nhất thiết cần nằm:
vĩnh viễn trên desktop.
Có thể áp dụng:
retention policy
cho các bản sao tạm.
Thời hạn cụ thể phải căn cứ:
mục đích và quy định áp dụng.
20. Không nên lưu dữ liệu XML tùy tiện trên dịch vụ cá nhân
Các kho lưu trữ cá nhân, email cá nhân hoặc nền tảng không được bệnh viện quản trị có thể làm dữ liệu:
ra khỏi phạm vi kiểm soát tổ chức.
Nguyên tắc nên là:
chỉ lưu ở hệ thống hoặc dịch vụ đã được phê duyệt.
21. USB và thiết bị lưu trữ rời cần được xem là kênh rủi ro
Dữ liệu trên USB có thể:
- mất;
- sao chép;
- bị nhiễm mã độc;
- không còn kiểm soát sau khi rời bệnh viện.
Nếu nghiệp vụ không bắt buộc:
nên hạn chế.
Nếu buộc phải dùng:
cần có biện pháp bảo vệ phù hợp.
22. Mã hóa dữ liệu lưu trữ là một control kỹ thuật hữu ích
Đối với:
- laptop;
- ổ lưu trữ di động;
- backup;
- archive;
có thể sử dụng encryption-at-rest phù hợp.
Tuy nhiên encryption chỉ là:
một lớp bảo vệ.
Nếu tài khoản đã bị lộ và user có quyền giải mã thì:
dữ liệu vẫn có thể bị truy cập.
23. Cần bảo vệ dữ liệu khi truyền
XML có thể được truyền giữa:
- HIS và Dr5;
- Dr5 và server khác;
- backup system;
- người dùng và web application.
Nên sử dụng:
kênh truyền được bảo vệ phù hợp.
Không nên gửi dữ liệu người bệnh:
qua kênh plaintext hoặc không được quản trị.
24. File XML không nên được gửi qua ứng dụng chat tùy tiện
Trong thực tế, cách nhanh nhất khi xử lý lỗi thường là:
“gửi file cho anh CNTT xem”.
Nhưng điều này làm dữ liệu đi vào:
- điện thoại;
- cloud của ứng dụng;
- máy cá nhân;
- backup của ứng dụng.
Tốt hơn nên có:
secure support workflow.
25. Hỗ trợ kỹ thuật nên sử dụng identifier hoặc sample tối thiểu khi có thể
Nếu developer chỉ cần:
một dòng XML gây lỗi,
không nhất thiết gửi:
toàn bộ episode.
Có thể cung cấp:
- minimal reproduction;
- masked data;
- synthetic sample.
Đây là data minimization trong support workflow.
26. Lưu trữ production XML phải có cấu trúc
Không nên để:
hàng triệu file XML
trong các thư mục tùy ý mà không biết:
- file nào là bản gửi;
- file nào là bản tạm;
- file nào là test;
- file nào đã ký.
Storage cần có:
classification + lifecycle.
27. Có thể phân biệt các lớp lưu trữ
Working copy
Dùng trong quá trình xử lý.
Submission copy
Exact payload đã gửi.
Evidence/archive copy
Dùng để tái dựng lịch sử.
Test copy
Chỉ dành cho kiểm thử.
Các lớp này không nên:
trộn lẫn.
28. Test copy không nên nằm trong production storage
Nếu test XML được lưu chung với production:
dễ gửi nhầm;
dễ thống kê nhầm;
khó quản lý quyền.
Môi trường cần:
logical separation.
29. Backup cũng chứa dữ liệu nhạy cảm
Nếu production được bảo vệ tốt nhưng backup:
mở cho nhiều user,
toàn bộ thiết kế bảo mật bị phá.
Backup cần có:
- quyền truy cập hạn chế;
- bảo vệ lưu trữ;
- retention;
- kiểm soát restore.
30. Backup không nên được dùng như data lake cho phân tích
Mục đích chính của backup là:
phục hồi.
Nếu cần analytics:
tạo analytical dataset có governance riêng.
Không nên mount:
backup production
cho người phân tích đọc trực tiếp.
31. Restore cũng là một hành động nhạy cảm
Khôi phục database production sang một máy test có thể vô tình tạo:
bản sao toàn bộ người bệnh.
Vì vậy restore phải biết:
target environment.
Không chỉ:
source backup.
32. Tách production và development là nguyên tắc quan trọng
Developer không nên mặc định có:
toàn bộ production data.
Development nên ưu tiên:
synthetic data.
Điều này vừa:
- giảm rủi ro bảo mật;
- làm test tái lập tốt hơn;
- giảm phụ thuộc dữ liệu bệnh nhân.
33. Synthetic data nên là lựa chọn mặc định cho unit test
Nếu cần kiểm:
arithmetic;
format;
catalog membership;
sequence;
không có lý do phải sử dụng:
tên người bệnh thật.
Synthetic fixture thường:
tốt hơn.
34. Real-world data chỉ nên dùng khi synthetic data không đủ
Có những lỗi chỉ xuất hiện do:
- complexity thực tế;
- legacy encoding;
- nhiều table;
- workflow bất thường.
Khi đó có thể sử dụng:
real-world corpus
nhưng phải có:
governance phù hợp.
35. Khử định danh không đơn giản là xóa họ tên
Một hồ sơ vẫn có thể được nhận diện nếu còn:
- CCCD;
- số thẻ;
- điện thoại;
- địa chỉ;
- mã bệnh nhân;
- ngày tháng kết hợp đặc biệt;
- identifiers khác.
Do đó de-identification phải xem:
toàn bộ tập dữ liệu.
36. Pseudonymization khác anonymization
Pseudonymization
Thay identifier bằng mã khác nhưng về nguyên tắc vẫn có thể liên kết lại thông qua key hoặc mapping riêng.
Anonymization
Mục tiêu là làm mất khả năng liên hệ dữ liệu với cá nhân theo mức độ phù hợp với mục tiêu sử dụng.
Trong thực tế kiểm thử, pseudonymization thường hữu ích hơn vì còn giữ:
quan hệ giữa các bảng.
Nhưng nó vẫn cần:
bảo vệ dữ liệu.
37. Dữ liệu đã pseudonymize không nên mặc nhiên coi là “không còn nhạy cảm”
Nếu mapping key còn tồn tại hoặc bộ dữ liệu có nhiều quasi-identifiers, vẫn có thể:
tái nhận diện.
Do đó access control vẫn cần.
38. Khử định danh phải bảo tồn logic cần kiểm thử
Nếu test cần:
cùng một bệnh nhân qua nhiều episode,
không được random mỗi MA_BN độc lập khiến relation vỡ.
Nếu test rolling-window cần:
timeline,
không nên làm biến dạng ngày đến mức mất behavior.
De-identification phải:
bảo mật nhưng vẫn giữ semantic cần thiết.
39. Không sử dụng production identifiers trong dữ liệu đào tạo nếu không cần
Một tài liệu hướng dẫn có thể dùng:
BN001
thay vì:
tên thật.
Một screenshot training cũng nên xem xét:
masking.
Không phải cứ dữ liệu chỉ dùng nội bộ là:
không cần bảo vệ.
40. Đào tạo nên ưu tiên case giả lập
Để dạy:
- cách đọc XML;
- xử lý finding;
- sử dụng Dr5;
synthetic case thường:
đủ.
Điều này giảm đáng kể:
rủi ro privacy.
41. Nếu dùng case thực để đào tạo, cần mục tiêu rõ
Một case thực có thể có giá trị cao trong đào tạo chuyên môn nhưng phải xem:
- ai được tham gia;
- cần dữ liệu nào;
- có thể giảm identifiers không;
- tài liệu sau buổi học được lưu ở đâu.
Không nên copy:
toàn bộ hồ sơ production
chỉ vì thuận tiện.
42. Screenshot cũng là dữ liệu
Một screenshot của Dr5 có thể chứa:
- tên;
- mã bệnh nhân;
- chẩn đoán;
- chi phí.
Khi đưa screenshot vào:
- PowerPoint;
- tài liệu hướng dẫn;
- nhóm chat;
nó trở thành:
một bản sao dữ liệu.
Do đó screenshot cũng phải được quản trị.
43. Screen recording còn có rủi ro lớn hơn
Một video demo có thể vô tình ghi:
hàng chục hồ sơ
trong lúc cuộn màn hình.
Môi trường training/demo nên:
dùng dữ liệu giả lập khi có thể.
44. Dữ liệu đưa vào AI hoặc dịch vụ bên ngoài cần được xem như một hành vi chia sẻ
Nếu người dùng copy XML vào:
một dịch vụ AI;
một website phân tích;
một công cụ bên ngoài bệnh viện,
thì dữ liệu đã rời khỏi hệ thống nội bộ.
Không nên coi:
“chỉ dùng để hỏi kỹ thuật”
là lý do tự động hợp lệ.
45. Dùng AI phải theo chính sách của tổ chức
Bệnh viện cần xác định:
- công cụ nào được phép;
- dữ liệu nào được phép gửi;
- khi nào cần khử định danh;
- ai chịu trách nhiệm.
Không nên để từng người dùng:
tự quyết định.
46. Dr5 development có thể sử dụng synthetic XML generator
Đây là một giải pháp rất phù hợp với kiến trúc Dr5. Có thể xây:
- hồ sơ hợp lệ;
- hồ sơ lỗi field;
- hồ sơ payment-condition;
- hồ sơ cross-table;
- hồ sơ temporal boundary.
Nhờ đó developer có dataset phong phú mà:
không cần dữ liệu thật.
47. Real-world regression corpus cần được quản lý riêng
Nếu dự án giữ một tập hồ sơ thực đã khử định danh để regression:
- không nên để trong public repository;
- cần quyền hạn chế;
- có version;
- có provenance;
- có mục đích rõ.
Regression corpus là:
một tài sản dữ liệu.
48. Source-control repository không nên chứa production secrets
Không nên commit:
- production database dump;
- XML thật chưa khử định danh;
- password;
- private key;
- access token.
Repository có thể có:
synthetic fixtures.
Không nên biến Git thành:
nơi lưu hồ sơ bệnh nhân.
49. Chữ ký số và private key cần được bảo vệ riêng
Nếu hệ thống dùng chữ ký điện tử cho payload, private key hoặc credential ký cần mức bảo vệ cao.
Không nên:
- copy key vào source code;
- gửi qua chat;
- chia sẻ tài khoản ký.
Bảo mật signing identity là một phần của:
integrity và non-repudiation của submission.
50. Không dùng chung credential ký nếu cơ chế yêu cầu nhận diện cá nhân hoặc đơn vị cụ thể
Việc ai được quyền ký và ký dưới danh nghĩa nào phải:
tuân theo cơ chế tổ chức và pháp lý áp dụng.
Dr5 không nên tự tạo:
signing authority.
Nó chỉ nên quản lý:
quyền kỹ thuật theo thẩm quyền đã được xác lập.
51. Log phải đủ để audit nhưng không nên chứa quá nhiều dữ liệu nhạy cảm
Một anti-pattern là ghi toàn bộ:
XML payload
vào application log mỗi request.
Điều này tạo thêm nhiều bản sao:
- log server;
- monitoring;
- backup.
Log chỉ nên chứa:
thông tin cần cho vận hành.
Payload đầy đủ nếu cần lưu:
nên ở evidence storage thích hợp.
52. Error message cũng có thể làm lộ dữ liệu
Không nên hiển thị:
toàn bộ record
trong error page cho user không cần.
Đặc biệt không nên để:
stack trace + patient data
xuất hiện trên giao diện công khai.
53. Monitoring system cũng cần kiểm soát quyền
Nếu application gửi:
error logs
đến monitoring platform,
phải xem:
dữ liệu nào đang được gửi.
Một hệ thống monitoring bên ngoài có thể trở thành:
nơi lưu bản sao thông tin bệnh nhân.
54. Dữ liệu test không nên được gửi lên hệ thống BHXH production
Tách môi trường giúp tránh:
test payload
trộn với:
hồ sơ thật.
Test cần có:
endpoint/configuration phù hợp.
Không dựa vào:
người dùng nhớ “đừng bấm gửi”.
55. Môi trường test phải có dấu hiệu nhận diện rõ
Ví dụ:
banner TEST;
hostname khác;
màu giao diện khác nếu phù hợp.
Mục tiêu là giảm:
human error.
56. Production credential không nên dùng trong test
Nếu môi trường test bị compromise nhưng đang dùng:
production credential,
boundary giữa hai môi trường gần như mất.
Tốt hơn:
credentials tách biệt.
57. Môi trường test không nên có quyền kết nối tùy tiện sang production database
Có thể cho phép:
controlled read
trong một số trường hợp đặc biệt.
Nhưng mặc định nên:
network/access separation.
58. Dữ liệu chia sẻ nội bộ vẫn cần purpose limitation
Một đơn vị được phép xem dữ liệu để:
xử lý hồ sơ
không có nghĩa được phép dùng cùng dữ liệu để:
nghiên cứu;
giảng dạy;
thử phần mềm
mà không có governance phù hợp.
Quyền truy cập gắn với:
mục đích.
59. Chia sẻ liên khoa nên theo workflow, không theo copy file
Nếu khoa cần xem một finding, tốt hơn:
cấp quyền xem case trên Dr5.
Không cần:
gửi file XML qua email.
Điều này giữ dữ liệu:
trong audit boundary.
60. Link có phân quyền tốt hơn file attachment trong nhiều trường hợp
Một file attachment sau khi gửi:
người nhận có thể tải và chuyển tiếp.
Một link nội bộ có:
- authentication;
- authorization;
- revocation;
- logging.
Vì vậy workflow nên ưu tiên:
controlled access
thay vì:
uncontrolled copies.
61. External sharing cần mức kiểm soát cao hơn
Khi dữ liệu phải chia sẻ cho:
- vendor;
- chuyên gia;
- đối tác;
cần xác định:
- phạm vi;
- mục đích;
- dữ liệu tối thiểu;
- thời gian;
- phương thức truyền;
- trách nhiệm của bên nhận.
Không mặc định:
có hợp đồng CNTT = được xem toàn bộ dữ liệu.
62. Vendor support nên dùng masked data khi có thể
Một lỗi phần mềm có thể được tái hiện bằng:
synthetic data.
Nếu buộc phải xem production data, access nên:
- có thời hạn;
- được giám sát;
- thu hồi sau xử lý.
63. Remote support là một privileged activity
Nếu vendor remote vào server:
có thể nhìn dữ liệu trực tiếp.
Do đó nên:
- cấp quyền tạm;
- log session nếu hạ tầng cho phép;
- không chia sẻ tài khoản cá nhân của nhân viên.
64. Không gửi database dump cho vendor nếu chỉ cần một sample
Đây là nguyên tắc:
minimum necessary data.
Một lỗi của một field không cần:
hàng triệu người bệnh.
65. Archive cần quyền truy cập riêng
Dữ liệu cũ ít được dùng nhưng vẫn có:
giá trị và độ nhạy cảm.
Do đó không nên vì “ít dùng” mà:
mở quyền rộng.
Archive access có thể:
chặt hơn production thường ngày.
66. Retention phải được thiết kế có chủ đích
Không nên:
lưu mãi mọi file tạm
chỉ vì storage còn chỗ.
Ngược lại cũng không nên:
xóa bằng chứng cần thiết
chỉ vì file cũ.
Retention cần phân biệt:
- submission evidence;
- audit;
- temporary export;
- test dataset;
- backup.
67. Hết thời gian sử dụng phải có disposal phù hợp
Xóa dữ liệu không chỉ:
xóa shortcut.
Tùy hệ thống, cần bảo đảm:
bản sao không còn được sử dụng ngoài policy.
Cơ chế cụ thể phụ thuộc:
storage architecture.
68. Dữ liệu nhạy cảm không nên nằm trong thư mục web public
Các thư mục:
webroot/public_html
không phải nơi lưu:
raw XML production
nếu không có lý do và bảo vệ phù hợp.
Một cấu hình web sai có thể:
làm file được tải trực tiếp.
69. File permission vẫn rất quan trọng
Ngay cả khi ứng dụng có RBAC, nếu filesystem cho mọi user đọc:
raw files,
security bị bypass.
Cần kiểm soát:
- owner;
- group;
- permissions.
70. Database permission cũng phải tách theo service
Không phải mọi application account đều cần:
quyền
ALL PRIVILEGES.
Read-only analytics có thể chỉ:
SELECT.
Exporter có thể cần scope khác.
Least privilege áp dụng:
cả application service accounts.
71. Credentials phải được quản lý ngoài source code khi có thể
Không nên lưu:
password production
trong repository.
Có thể dùng:
secret/config management phù hợp.
Cách cụ thể phụ thuộc:
hạ tầng.
72. Audit quyền truy cập quan trọng như audit chỉnh sửa
Một user không sửa gì nhưng:
tải hàng triệu hồ sơ
vẫn là một sự kiện đáng quan tâm.
Do đó audit nên bao phủ:
access/export events rủi ro cao,
không chỉ:
UPDATE.
73. Không cần log mọi lần xem field nếu điều đó gây quá tải vô ích
Logging cũng cần:
risk-based.
Có thể ưu tiên:
- bulk view;
- export;
- privileged access;
- sensitive-record access;
- unusual patterns.
Không nhất thiết:
từng click nhỏ
đều phải thành audit event nếu không tạo giá trị.
74. Có thể phát hiện hành vi bất thường
Ví dụ:
- user thường xem 20 hồ sơ/ngày đột nhiên export 50.000;
- login từ context bất thường;
- bulk download ngoài giờ.
Đây có thể là:
security signal.
Nhưng signal chưa đồng nghĩa:
vi phạm.
Cần review.
75. Không dùng security analytics để kết tội người dùng tự động
Giống Chương 7 và 8:
outlier ≠ violation.
Một admin có thể download nhiều dữ liệu vì:
backup/migration được phê duyệt.
Do đó analytics tạo:
review candidate.
Không tự:
kết luận misconduct.
76. Incident response cần biết dữ liệu nào đã bị ảnh hưởng
Khi có security incident, bệnh viện cần trả lời:
- system nào;
- user nào;
- data domain nào;
- period nào;
- số record bao nhiêu;
- có export không.
Nếu không có log và lineage:
phạm vi incident khó xác định.
77. Security incident cũng phải tạo bài học hệ thống
Sau incident cần xem:
- quyền quá rộng?
- credential dùng chung?
- export không kiểm soát?
- retention quá dài?
Kết quả phải quay về:
control improvement.
78. Phân quyền và data ownership phải gắn nhau
Bài 9.1 đã xác định:
ai chịu trách nhiệm dữ liệu.
Bài 9.3 bổ sung:
ai được xem và làm gì với dữ liệu đó.
Ownership không chỉ là trách nhiệm mà còn là cơ sở để:
thiết kế access policy.
79. Người chịu trách nhiệm dữ liệu không nhất thiết được quyền export toàn bộ
Data Owner có thể có quyền:
phê duyệt hoặc xác nhận.
Nhưng bulk export có thể vẫn cần:
control riêng.
Quyền nghiệp vụ và quyền kỹ thuật:
không đồng nhất.
80. Dr5 nên thiết kế access theo scope
Ví dụ scope có thể bao gồm:
- facility;
- department;
- case;
- data domain;
- function.
Một bác sĩ có thể xem:
bệnh nhân thuộc phạm vi khoa.
BHYT có thể xem:
hồ sơ cần review toàn viện
nhưng không nhất thiết có:
quyền chỉnh clinical note.
81. Scope cần được kiểm tra server-side
Không nên chỉ:
ẩn nút trên UI.
Nếu API vẫn trả:
dữ liệu đầy đủ
cho user không có quyền,
security không đạt.
Authorization phải thực hiện:
ở backend.
82. API token cũng là tài khoản
Integration giữa:
- HIS;
- Dr5;
- LIS;
- billing
thường dùng service account/token.
Các credential này cũng cần:
- scope;
- rotation khi phù hợp;
- không dùng chung không kiểm soát;
- audit.
83. Service account không nên giả danh một người dùng cá nhân
Integration nên có identity:
riêng.
Nhờ đó audit phân biệt:
system action
và:
human action.
84. API response nên trả dữ liệu tối thiểu
Nếu HIS chỉ cần:
finding code + message,
không cần Dr5 gửi:
toàn bộ HSBA trong response.
Đây là minimization ở:
integration layer.
85. Cache cũng có thể chứa dữ liệu bệnh nhân
Khi tối ưu hiệu năng, dữ liệu có thể nằm trong:
- Redis;
- temp files;
- browser cache.
Security design phải nhớ:
các secondary storage này.
Không chỉ database chính.
86. Temporary files cần cleanup
XML được tạo tạm để:
- validate;
- sign;
- upload
không nên nằm:
vô thời hạn trong
/tmp.
Có thể áp dụng:
lifecycle cleanup.
87. Local browser download là một boundary
Khi user download file, hệ thống mất phần lớn khả năng:
kiểm soát file sau đó.
Vì vậy trước download cần cân nhắc:
có thực sự cần không?
88. Print cũng tạo một bản sao
Bản in:
- có thể bị bỏ quên;
- chụp ảnh;
- mang ra ngoài.
Do đó dữ liệu XML/chi tiết hồ sơ không nên in:
tùy tiện.
Paper output cũng thuộc:
information security lifecycle.
89. Dữ liệu đào tạo nên có watermark/context nếu cần
Nếu vẫn sử dụng:
dataset/screenshot cho training,
có thể đánh dấu:
TEST / TRAINING
để tránh:
nhầm với dữ liệu production.
Đây là control vận hành hữu ích.
90. Không nên đưa production data vào tài liệu công khai
Tài liệu:
- website;
- hội thảo;
- bài viết;
- GitHub;
cần đặc biệt tránh:
identifiers người bệnh.
Case minh họa nên:
synthetic hoặc được xử lý phù hợp.
91. Kiểm thử bảo mật phải là một phần của release
Ngoài business regression, release Dr5 nên kiểm:
- authorization;
- export permission;
- API scope;
- data leakage trong error;
- access to archive.
Không chỉ:
rule engine.
92. Một permission bug có thể nghiêm trọng hơn một rule bug
Nếu rule sai:
một nhóm finding có thể sai.
Nếu authorization sai:
hàng nghìn hồ sơ có thể bị truy cập trái phạm vi.
Do đó security regression phải:
được ưu tiên tương xứng.
93. Test phải có trường hợp “user không được quyền”
Nhiều test chỉ kiểm:
authorized user can access.
Cần test:
unauthorized user cannot access.
Đây là negative security testing.
94. Export endpoint cần test riêng
Một lỗi phổ biến là UI chặn export nhưng API:
vẫn cho gọi trực tiếp.
Do đó test quyền phải đi:
tới API/backend.
95. Phân quyền phải được kiểm tra lại khi role thay đổi
Một role mới hoặc permission mới có thể vô tình:
mở dữ liệu rộng hơn dự kiến.
Role changes cần:
impact review.
96. Bảo mật không chỉ là nhiệm vụ của CNTT
CNTT xây control kỹ thuật, nhưng người dùng vẫn quyết định:
- có tải file không;
- có chia sẻ không;
- có dùng đúng mục đích không.
Bảo mật là:
trách nhiệm chung.
97. Tuy nhiên không nên đẩy trách nhiệm hoàn toàn cho người dùng
Một thông báo:
“Không được chia sẻ dữ liệu”
không đủ nếu hệ thống vẫn:
cho download toàn bộ với một click.
Control kỹ thuật phải hỗ trợ:
policy.
98. Policy và technology phải đi cùng nhau
Policy xác định:
ai được phép làm gì.
Technology thực thi:
quyền đó.
Audit chứng minh:
chuyện gì đã xảy ra.
Ba lớp phải:
thống nhất.
99. Ma trận hoạt động và control đề xuất
| Hoạt động | Control chính |
|---|---|
| Xem hồ sơ | RBAC/scope |
| Sửa dữ liệu | role + audit |
| Override | permission + reason |
| Bulk export | permission + logging/approval theo risk |
| Lưu archive | access + integrity + retention |
| Chia sẻ nội bộ | controlled link/workflow |
| Chia sẻ bên ngoài | minimum data + approval + secure channel |
| Development | synthetic data ưu tiên |
| Real-world testing | de-identification + restricted access |
| Training | synthetic/masked data |
| Backup | restricted storage + restore control |
100. Ma trận lựa chọn dữ liệu cho kiểm thử
| Mục tiêu | Nguồn ưu tiên |
|---|---|
| Unit test | synthetic |
| Rule boundary test | synthetic |
| Regression lỗi cụ thể | synthetic nếu tái hiện được |
| Integration complexity | synthetic/curated |
| Real-world edge case | de-identified real-world corpus |
| Demo | synthetic |
| Training | synthetic/masked |
| Performance test | generated synthetic volume |
Nguyên tắc là:
dùng dữ liệu thật ít nhất có thể nhưng đủ để đạt mục tiêu.
101. Mô hình “safe test data pipeline”
Có thể thiết kế:
Production candidate
→ assess need
→ extract minimal fields
→ de-identify/pseudonymize
→ validate utility
→ publish to restricted test storage
→ expire/delete according to policy.
Không nên:
production DB → copy thẳng sang dev.
102. Tập dữ liệu test phải có owner
Nếu một corpus được dùng lâu dài:
ai chịu trách nhiệm?
Cần biết:
- nguồn;
- purpose;
- access;
- update;
- retention.
Không để:
“thư mục test cũ của anh A”.
103. Khi không còn mục đích phải giảm hoặc xóa bản sao
Data minimization không chỉ áp dụng khi tạo dữ liệu mà còn:
khi mục đích kết thúc.
Một test corpus không còn sử dụng:
không nên tồn tại vô thời hạn chỉ vì không ai dọn.
104. Chương 9.3 không chỉ nhằm tránh rò rỉ
Mục tiêu còn là bảo vệ:
integrity và auditability.
Nếu user không có quyền nhưng vẫn sửa được:
dữ liệu mất integrity.
Nếu account dùng chung:
audit mất accountability.
Nếu production bị copy vào test rồi bị sửa:
không biết bản nào là authoritative.
Security và data quality:
gắn chặt với nhau.
105. Một hệ thống bảo mật tốt phải vẫn vận hành được
Nếu control quá phức tạp, người dùng sẽ tìm cách:
- dùng tài khoản chung;
- gửi file qua chat;
- copy ra USB.
Vì vậy thiết kế tốt phải làm con đường an toàn:
dễ hơn con đường không an toàn.
106. Ví dụ thay vì cấm chia sẻ bằng lời
Có thể cung cấp trong Dr5:
“Share review case”
với:
- user được chọn;
- quyền xem giới hạn;
- thời hạn nếu phù hợp;
- audit.
Người dùng không cần:
tải file rồi gửi.
Đây là cách công nghệ làm:
security usable.
107. Cần phân biệt bảo mật production với tính tiện lợi của analytics
Analyst thường muốn:
tải dữ liệu về Excel.
Nhưng nếu nhu cầu lặp lại thường xuyên, tốt hơn xây:
dashboard/query environment có kiểm soát.
Không tạo hàng trăm:
local spreadsheets.
108. Analytical dataset nên giảm identifiers khi không cần
Nếu phân tích:
chi phí theo khoa,
không cần:
họ tên người bệnh.
Bỏ identifiers giúp giảm:
exposure.
109. Không để quyền analytics vô tình trở thành quyền truy cập hồ sơ toàn diện
Một người cần:
aggregate statistics
không nhất thiết được xem:
row-level identifiable data.
Có thể cung cấp:
aggregated view.
110. Bảo mật phải được xem như một quá trình liên tục
Mỗi thay đổi:
- hệ thống mới;
- connector mới;
- role mới;
- export mới;
- AI integration mới;
đều có thể tạo:
data path mới.
Do đó security review phải nằm trong:
change management của Bài 9.6.
Kết luận
Dữ liệu XML chỉ an toàn khi bệnh viện kiểm soát được không chỉ server chứa dữ liệu mà toàn bộ vòng đời của việc truy cập, sao chép, lưu trữ, truyền nhận, chia sẻ và tái sử dụng. Thông tư 12/2026/TT-BTC đặt trách nhiệm trực tiếp lên cơ sở KCB trong việc quản lý và phân quyền tài khoản đúng mục đích, không sử dụng chung tài khoản, bảo đảm an toàn thông tin và bảo vệ thông tin cá nhân người bệnh.
Từ trách nhiệm này, bệnh viện cần xây dựng các control nội bộ dựa trên nguyên tắc least privilege, purpose limitation và data minimization: người dùng chỉ được xem dữ liệu cần cho nhiệm vụ; quyền xem không mặc nhiên bao gồm quyền sửa hoặc export; bulk export cần mức kiểm soát cao hơn truy cập thông thường; dữ liệu nên được giữ trong các hệ thống có phân quyền và audit thay vì sao chép thành nhiều file cá nhân; backup, archive và temporary files phải được bảo vệ như production data; còn môi trường development, testing, training và demo phải ưu tiên dữ liệu synthetic thay vì hồ sơ thật.
Khi bắt buộc phải sử dụng real-world data cho kiểm thử, cần giới hạn phạm vi dữ liệu, áp dụng de-identification hoặc pseudonymization phù hợp, tách môi trường, giới hạn quyền truy cập và quản lý corpus như một tài sản dữ liệu có mục đích rõ ràng. Việc gửi dữ liệu sang công cụ AI, dịch vụ bên ngoài hoặc vendor support cũng phải được xem là một hình thức chia sẻ dữ liệu chứ không chỉ là thao tác kỹ thuật.
Đối với Dr5-XML, mô hình bảo mật có thể được cô đọng thành:
Identity
→ Authentication
→ Role and scope
→ Minimum necessary access
→ Controlled copy/export
→ Protected storage and transmission
→ Auditable use
→ Controlled retention/disposal.
Và đối với đào tạo, phát triển và kiểm thử:
Synthetic first
→ de-identified real-world data only when necessary
→ restricted environment
→ minimum dataset
→ controlled lifecycle.
Nguyên tắc quan trọng nhất của toàn bài là:
Một bản sao dữ liệu vẫn là dữ liệu người bệnh; việc chuyển nó từ database sang XML, Excel, screenshot, backup, môi trường test hoặc công cụ phân tích không làm giảm trách nhiệm bảo vệ nó.
Khi nguyên tắc này được thực hiện xuyên suốt, bệnh viện vừa bảo vệ được thông tin người bệnh, vừa duy trì được tính toàn vẹn và khả năng truy vết của dữ liệu, đồng thời vẫn có thể sử dụng XML an toàn cho tiền giám định, phân tích, đào tạo, phát triển và cải tiến hệ thống.
- Đăng nhập để gửi ý kiến